现在越来越多用户在选软件、买服务、做对比时,不再去传统搜索引擎翻前几页链接,而是直接问 ChatGPT、豆包、DeepSeek。
围绕“怎么让 AI 推荐并引用自家品牌”,GEO(生成式引擎优化) 成了今年增长和营销圈最火的话题。但落到实操层面,市面上却充斥着大量似是而非的“玄学”:
- 拿一张单次提问“排第一”的截图当战报,却不敢开新对话再问第二遍;
- 只盯着一家 AI 测试,或者迷信网站诊断工具跑出来的分数;
- 搞不清官网该改什么、站外该发哪里,甚至靠盲目铺稿、虚构评分踩进监管红线。
GEO 之所以看起来像“玄学”,是因为缺了一手对账数据和统一的衡量尺子。
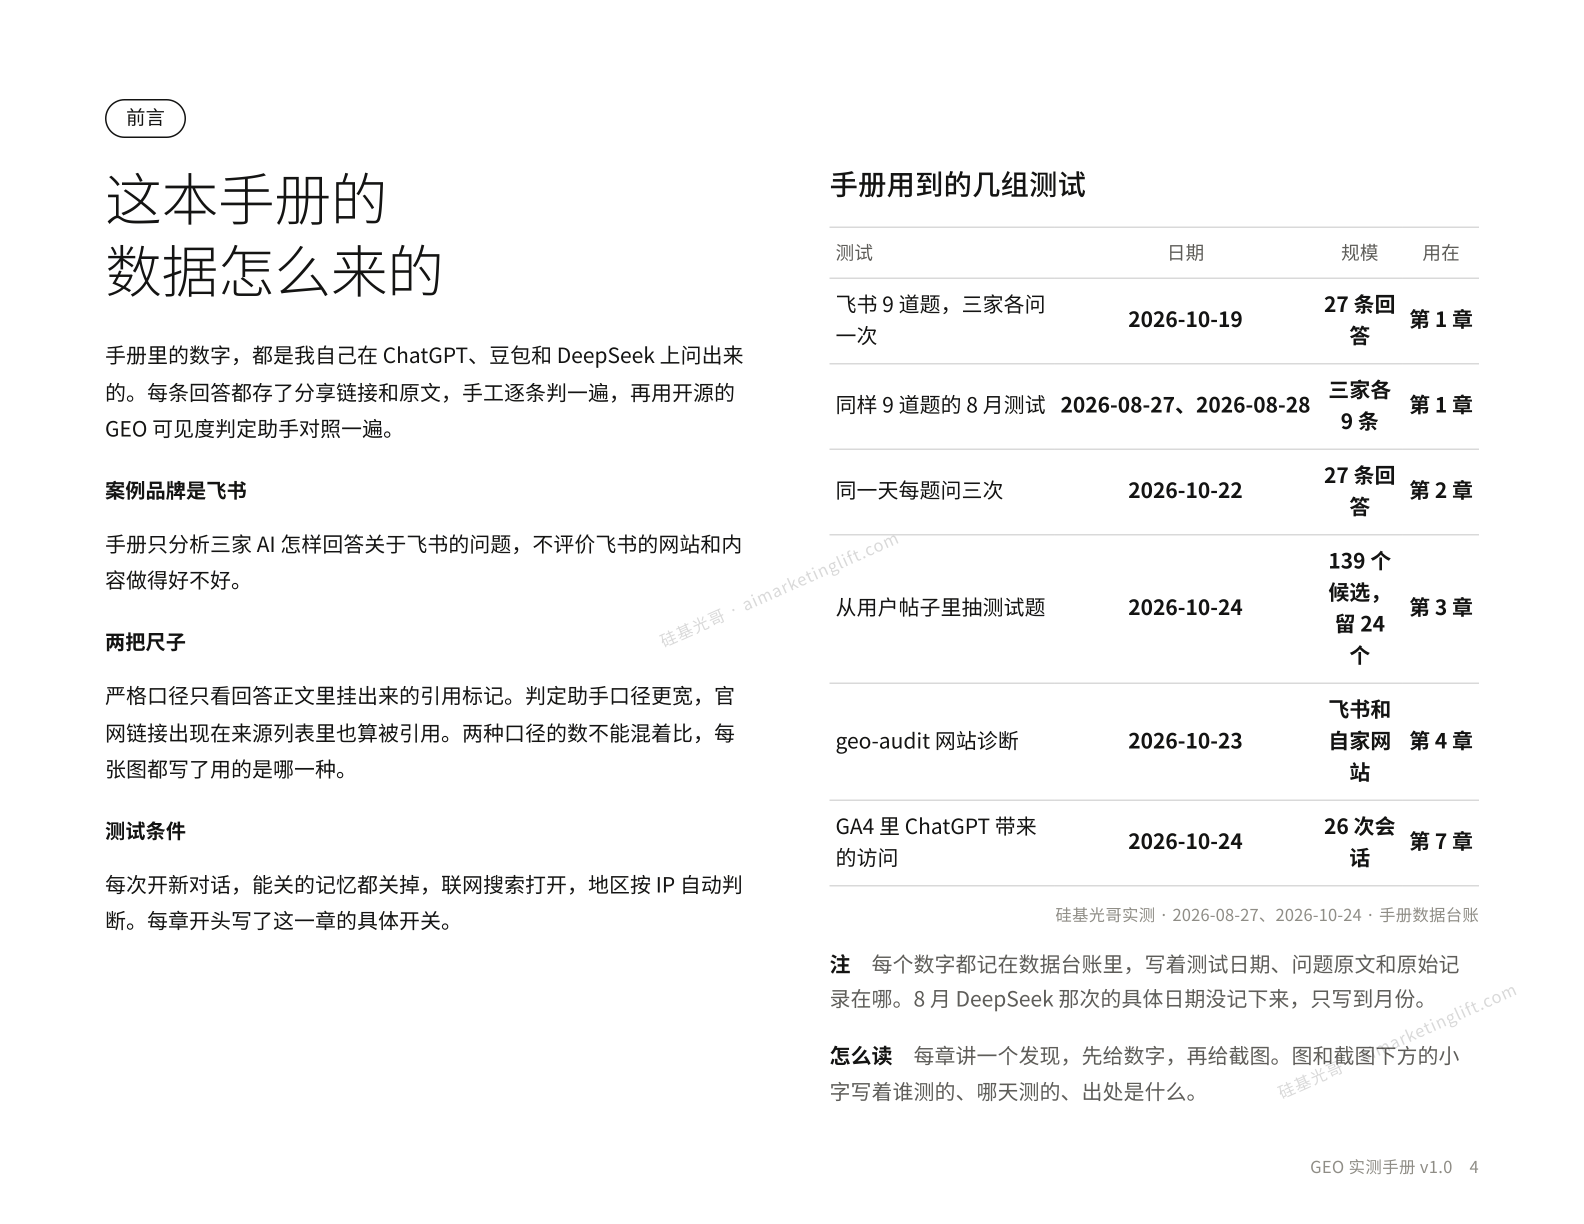
为了把这件事彻底测清楚,在 2026 年 8 月至 10 月期间,我以“飞书”和自家网站为样本,在 ChatGPT、豆包、DeepSeek 三家主流 AI 上跑完了 6 组完整测试:每条回答都存了分享链接和原文,手工逐条判一遍,再用开源的 GEO 可见度判定助手对照一遍。
今天,我把这 3 个月的数据台账、原始截图、站内外实操 SOP 和记录模板,整理成了这本 50 页横版 PDF《GEO 实测手册:AI 到底怎么推荐一个品牌》(v1.0 正式版),免费公开给大家。
00 先亮底牌:这本手册的数据怎么来的?
在拆解具体问题前,先交代这本手册的测试底盘与两把判定尺子:
- 6 组一手测试台账:涵盖飞书 9 道题三家 AI 横评(27 条回答)、8 月与 10 月跨周期复测、同日每题问三次波动测试(27 条回答)、从 V2EX 用户帖子与百度下拉词抽题审核(139 个候选筛留 24 个正式题)、
geo-audit网站诊断比对、以及 GA4 与 Bing 后台流量核对。 - 两把尺子,绝不混用:
- 严格口径:只看回答正文里明确挂出来的官网引用标记;
- 判定助手口径:官网链接出现在正文或来源列表里都算被引用。手册每张图下方均写明了所用口径、测试日期和出处。
下面,我直接用手册里的一手实测数据,把市面上最常见的 4 个 GEO“玄学” 逐一拆开,并给出可直接落地的硬核干货。
01 拆解“单平台与官网玄学”:AI 回答前,到底去哪读了你的品牌?
很多团队做 GEO 的第一反应是:去某一家 AI 问几个问题,然后闷头改自家官网。但实测数据给出了两个截然不同的真相:
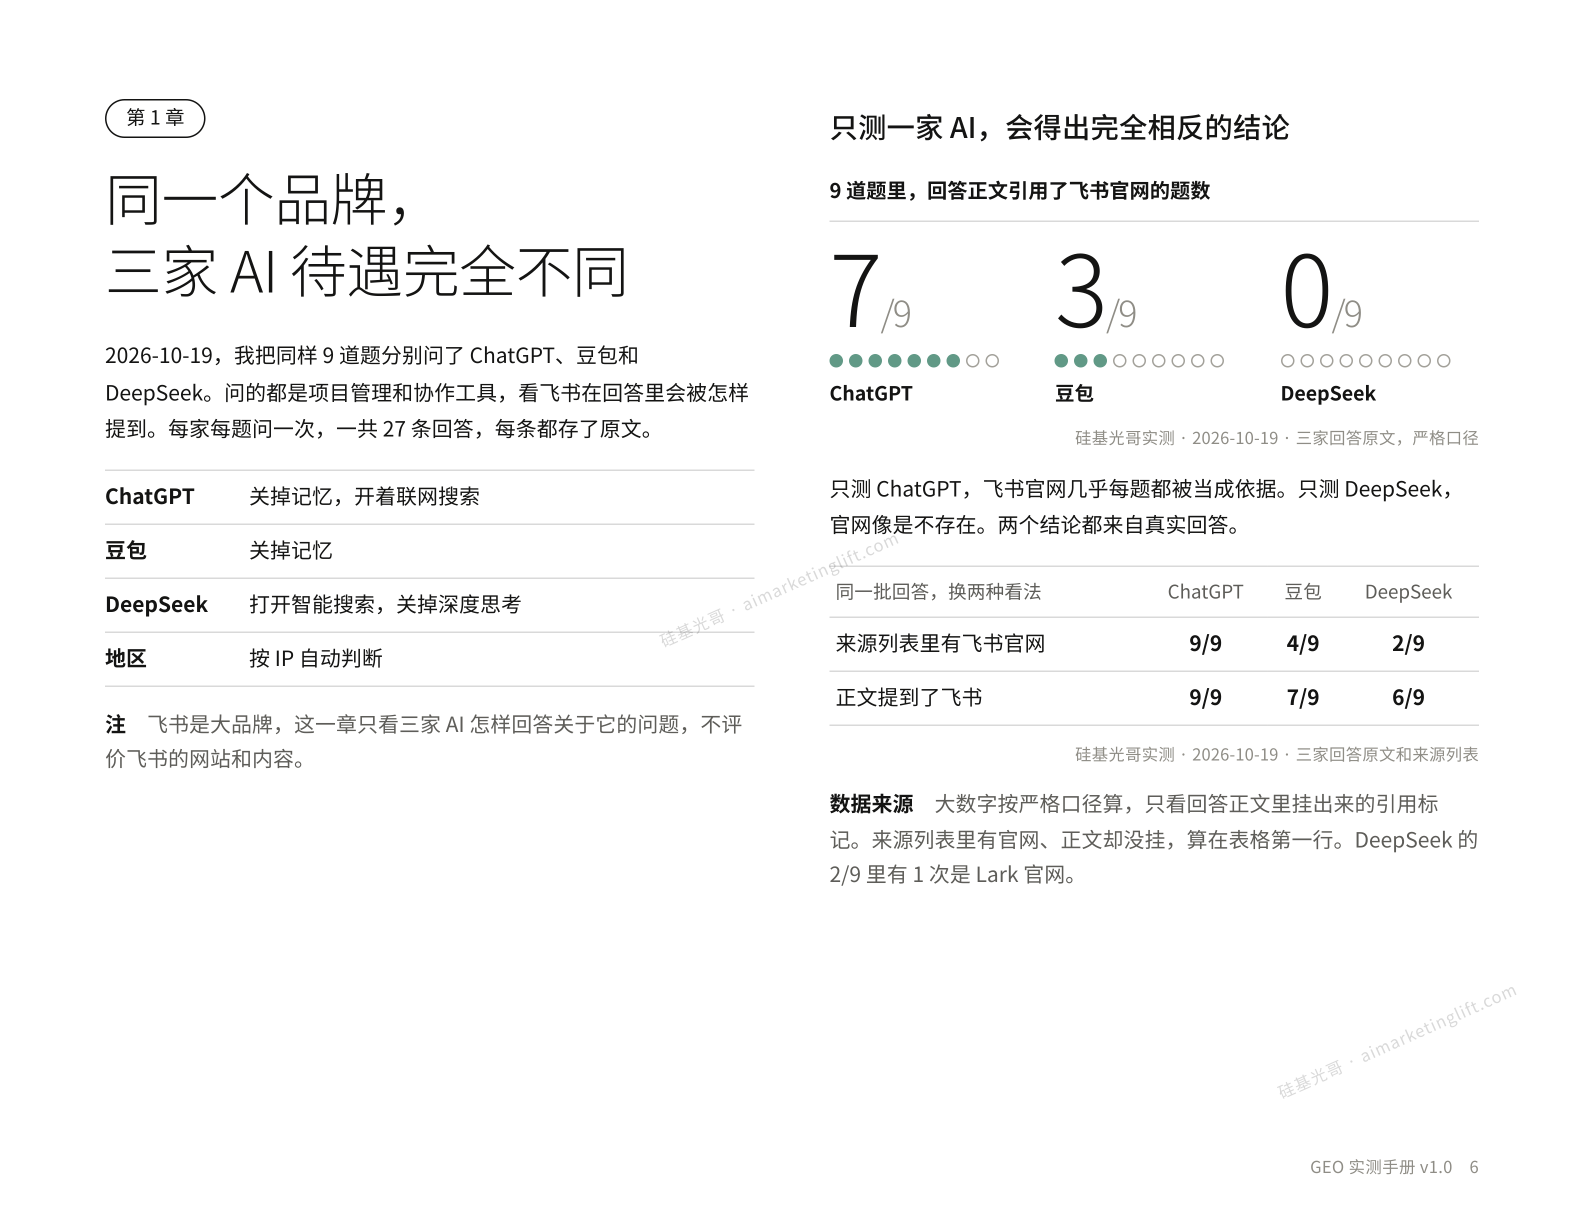
第一,只测一家 AI,会得出完全相反的结论。 我把同样的 9 道项目管理与协作工具选型题,分别问了 ChatGPT、豆包和 DeepSeek。按严格口径统计回答正文引用飞书官网的题数:
- ChatGPT:7/9
- 豆包:3/9
- DeepSeek:0/9
只测 ChatGPT,飞书官网几乎每题都被当成核心依据;只测 DeepSeek,官网像是不存在。三家结论完全一致的只有 1 道题,其余 8 道题在三家 AI 里的位置、说法和引用全不一样。
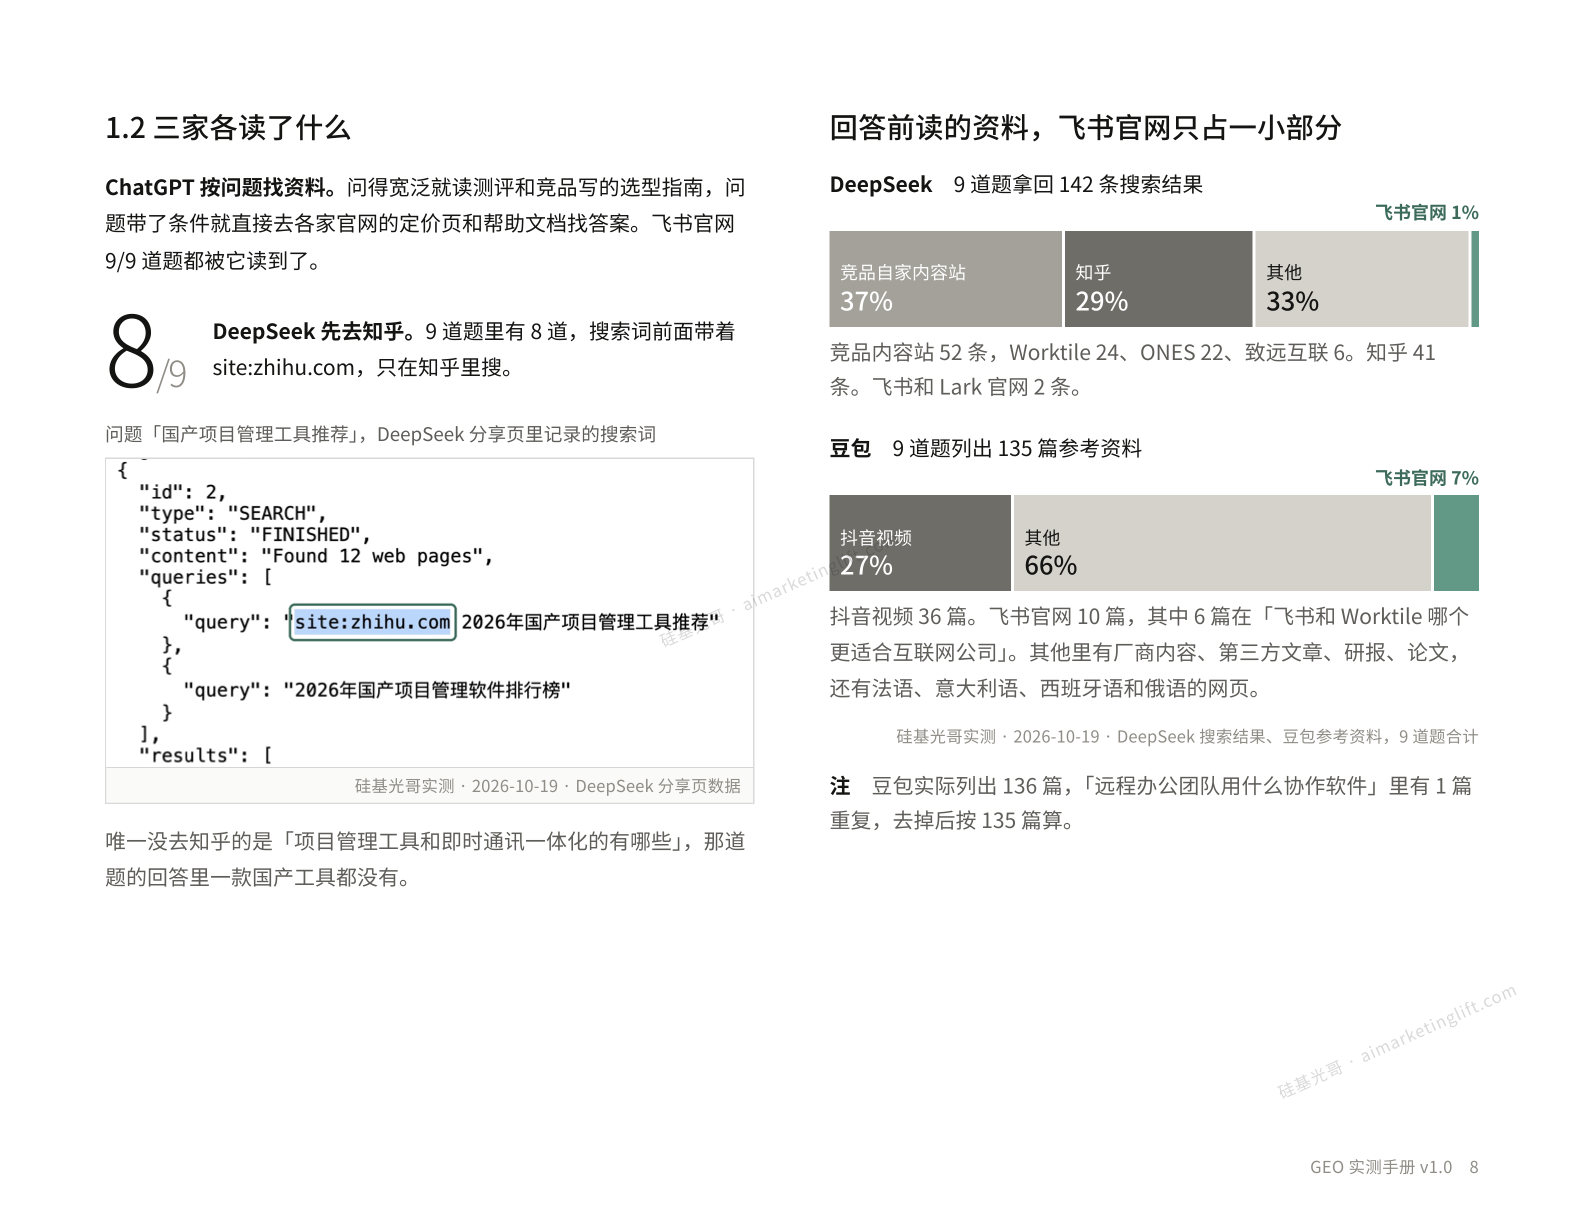
第二,AI 回答前读的资料里,品牌官网只占极小一部分。 扒开三家 AI 的搜索词记录和参考资料面板,数据非常直观:
- DeepSeek 先去知乎,且大量读竞品内容站:9 道题里有 8 道,DeepSeek 搜索词前面自动带着
site:zhihu.com;它拿回的 142 条搜索结果里,竞品自家内容站占了 37%(52 条:Worktile 24、ONES 22、致远互联 6),知乎占 29%(41 条),而飞书和 Lark 官网只有 2 条(占 1%)。 - 豆包读得最杂,抖音占四分之一:9 道题列出的 135 篇参考资料里,抖音视频占 27%(36 篇),官网仅占 7%。
- 谁写了选型指南,AI 就按谁的框架回答:在「企业级项目管理系统怎么选」这道题里,DeepSeek 读了致远互联的 5 篇选型指南并全部引用,结果飞书项目直接顺着对方的分类框架被归入轻量工具,句末跟着“能力有限”。
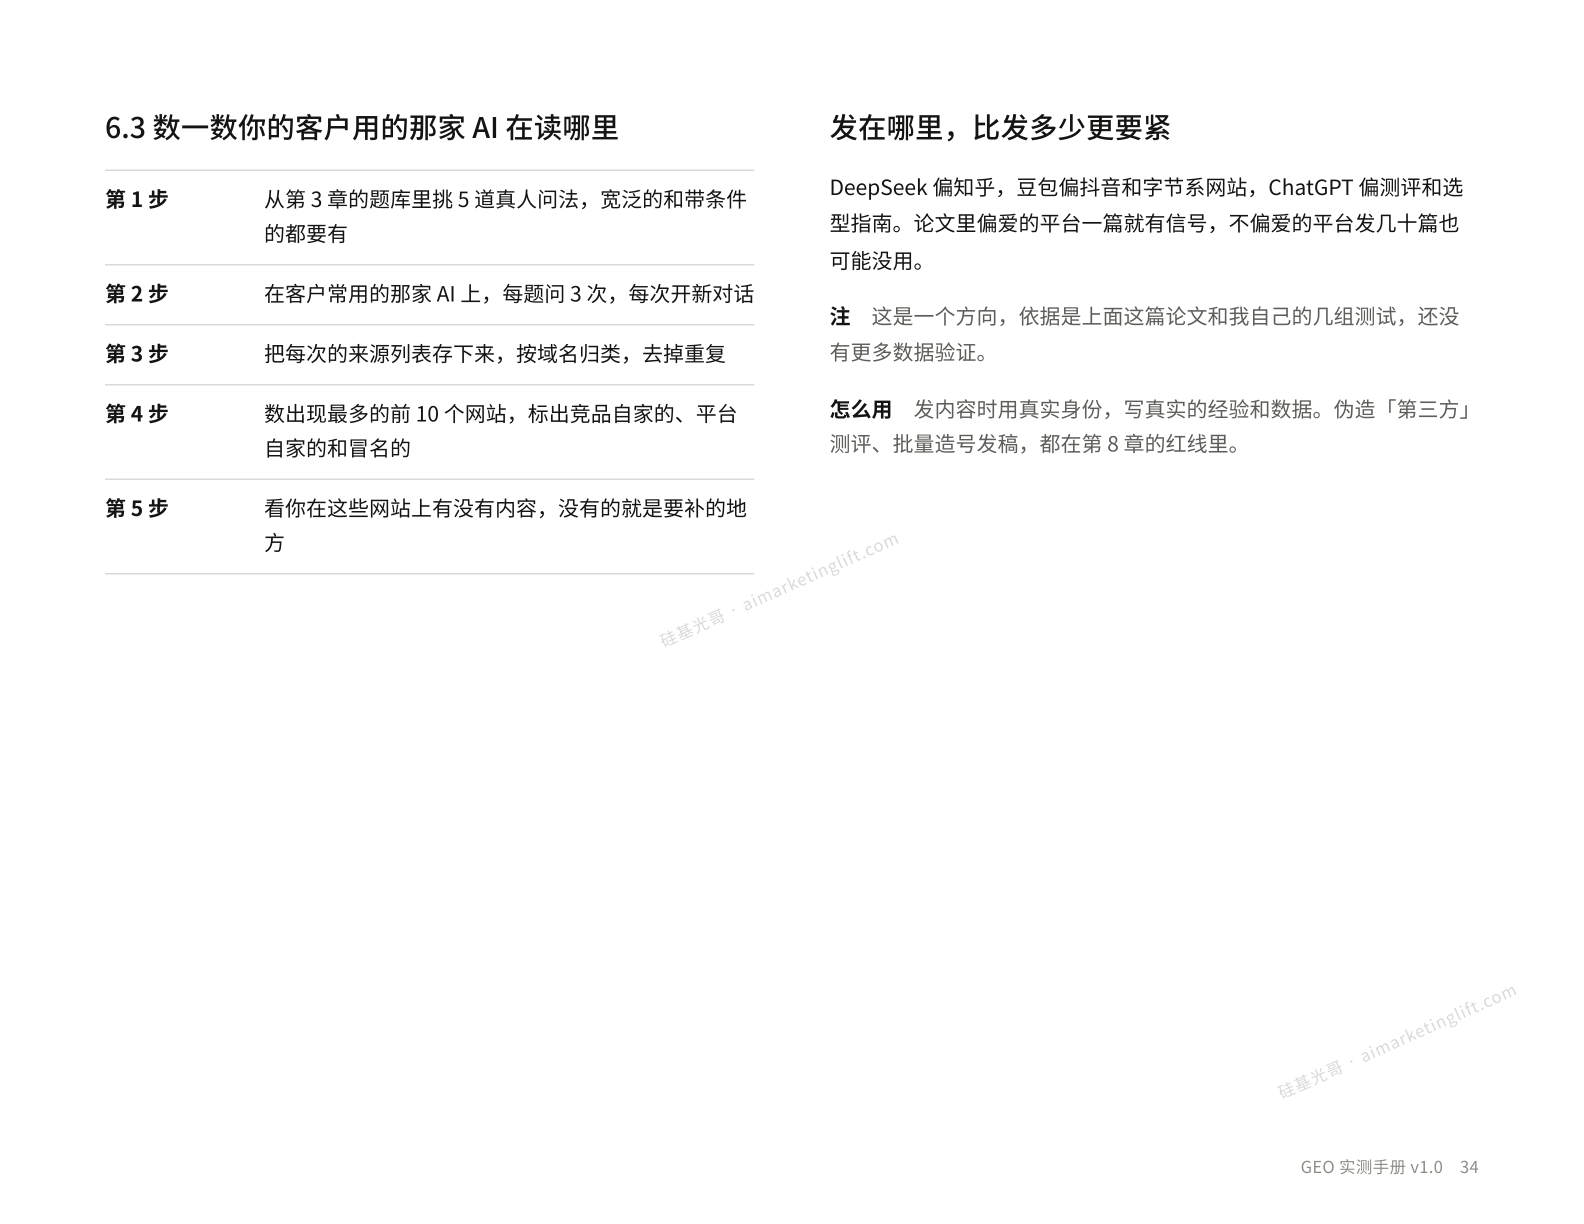
🛠️ 硬核实操|站外信源 5 步排查法(手册第 6 章) 发在哪里,比发多少更要紧。怎么找出你的客户常用的 AI 在读哪里?
- 挑题:从正式题库挑 5 道真人问法(宽泛题与带条件题都要有);
- 多轮提问:在客户常用的那家 AI 上,每题开新对话问 3 次;
- 域名归类:把每次来源列表存下来,按域名归类去重;
- 标出前 10:数出出现最多的前 10 个网站,标出竞品站、平台自留地和冒名网站(实测 ChatGPT 单次来源里曾出现 25 个仿冒官网,看来源必须按域名看,不能只看标题);
- 精准补缺:看自家在这前 10 个网站上有没有真实内容,没有的就是最该补的地方。
02 拆解“单张截图玄学”:测一次不算数,怎么测才算数?
市面上最常见的“玄学战报”,就是截一张品牌排第一的图交差。但我在手册第 2、3 章用两组实验拆穿了这个假象:
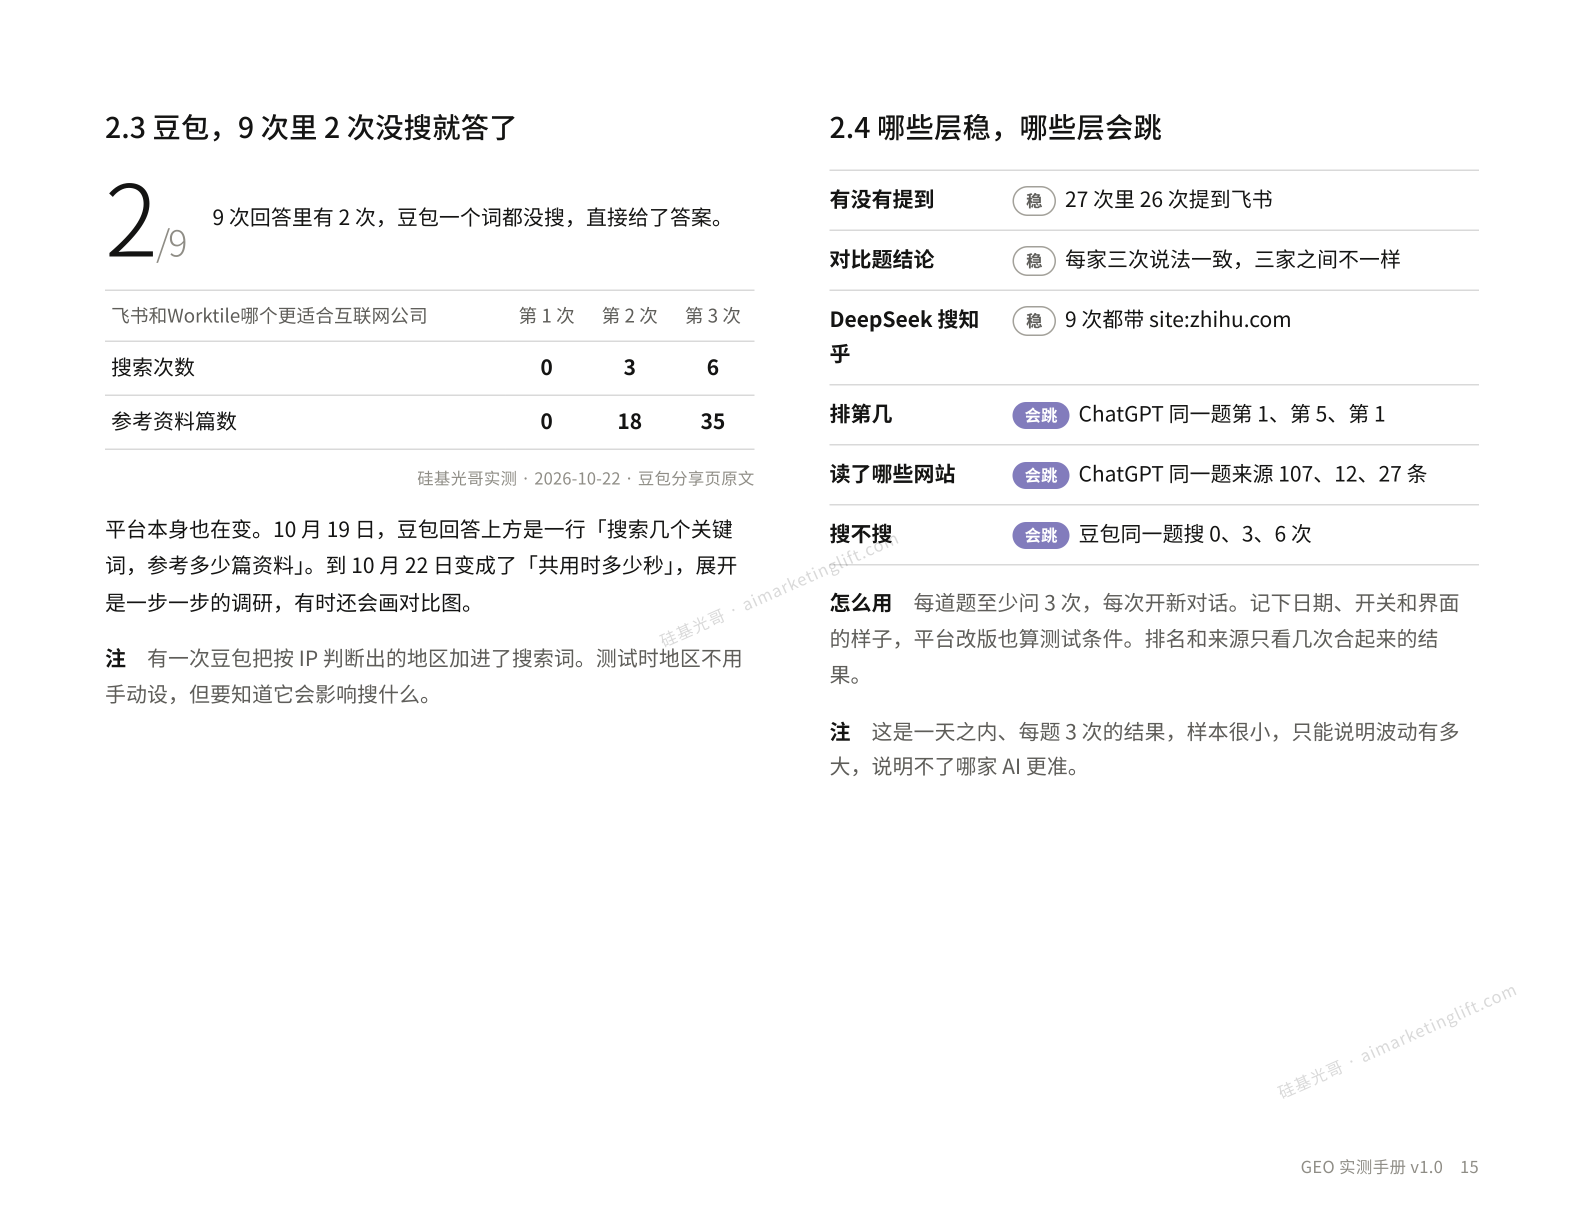
1. 同一道题同一天问三次,排名能从第 1 掉到第 5,来源条数差八九倍 我挑了 3 道题,同一天在三家 AI 上各问 3 次(每次开新对话、关记忆,一共 27 条回答)。 在 ChatGPT 上问「国产项目管理工具推荐」三次,飞书项目的位置分别是:第 1 名、第 5 名、第 1 名;来源面板读取的网站条数分别是:107 条(含官网 10 条)、12 条(官网 0 条)、27 条(官网 2 条)。 而在豆包上,9 次回答里有 2 次甚至一个词都没搜,直接给了答案(同一题搜索次数分别是 0 次、3 次、6 次)。
2. 选什么题,决定测出什么结果:带具体条件的真人问法才是试金石 如果只拿 AI 编出来的宽泛大词去测,你会以为自家品牌无处不在。 我从 V2EX 公开帖子和百度搜索下拉词里抽出 139 个问题,人工逐条审核去重,留下 24 道正式题(按“办公协作/项目管理”、“带品牌/不带品牌”分组)。 拿其中 5 道题在三家 AI 各问 3 次(45 条回答):4 道宽泛题里,三家 AI 9 次回答 100% 提到了飞书(3/3);但换成 V2EX 真人原句*「一个 10 人左右小团队,想私有化部署一套项目管理工具,求推荐。」*,三家 AI 9 次回答里飞书一次都没被提到(0/3、0/3、0/3)。
🛠️ 硬核实操|科学测试 3 条铁律(手册第 2~3 章)
- 题从真人问法里找:题库宁可小,也要每条都是真人原句;且必须同时包含宽泛推荐题与带人数、部署方式、预算限制的条件题。
- 带品牌与不带品牌分开算分:带品牌名的题(如“飞书和钉钉哪个收费高”)品牌本来就会出现,混在一起算会虚抬可见度。
- 每题至少问 3 次 + 人工抽查:每次开新对话,记录日期、联网/思考开关与界面改版;判定工具跑完后必须抽样回原文核对(实测 DeepSeek 曾 2/3 把飞书价格写错,而自动判定工具只判提及、不判事实对错)。
03 拆解“工具跑分与技术玄学”:网站这一层,到底哪些值得做?
围绕官网改造,目前有两个极端误区:一是迷信诊断工具打分,二是花大量精力折腾 llms.txt 等特殊标记。
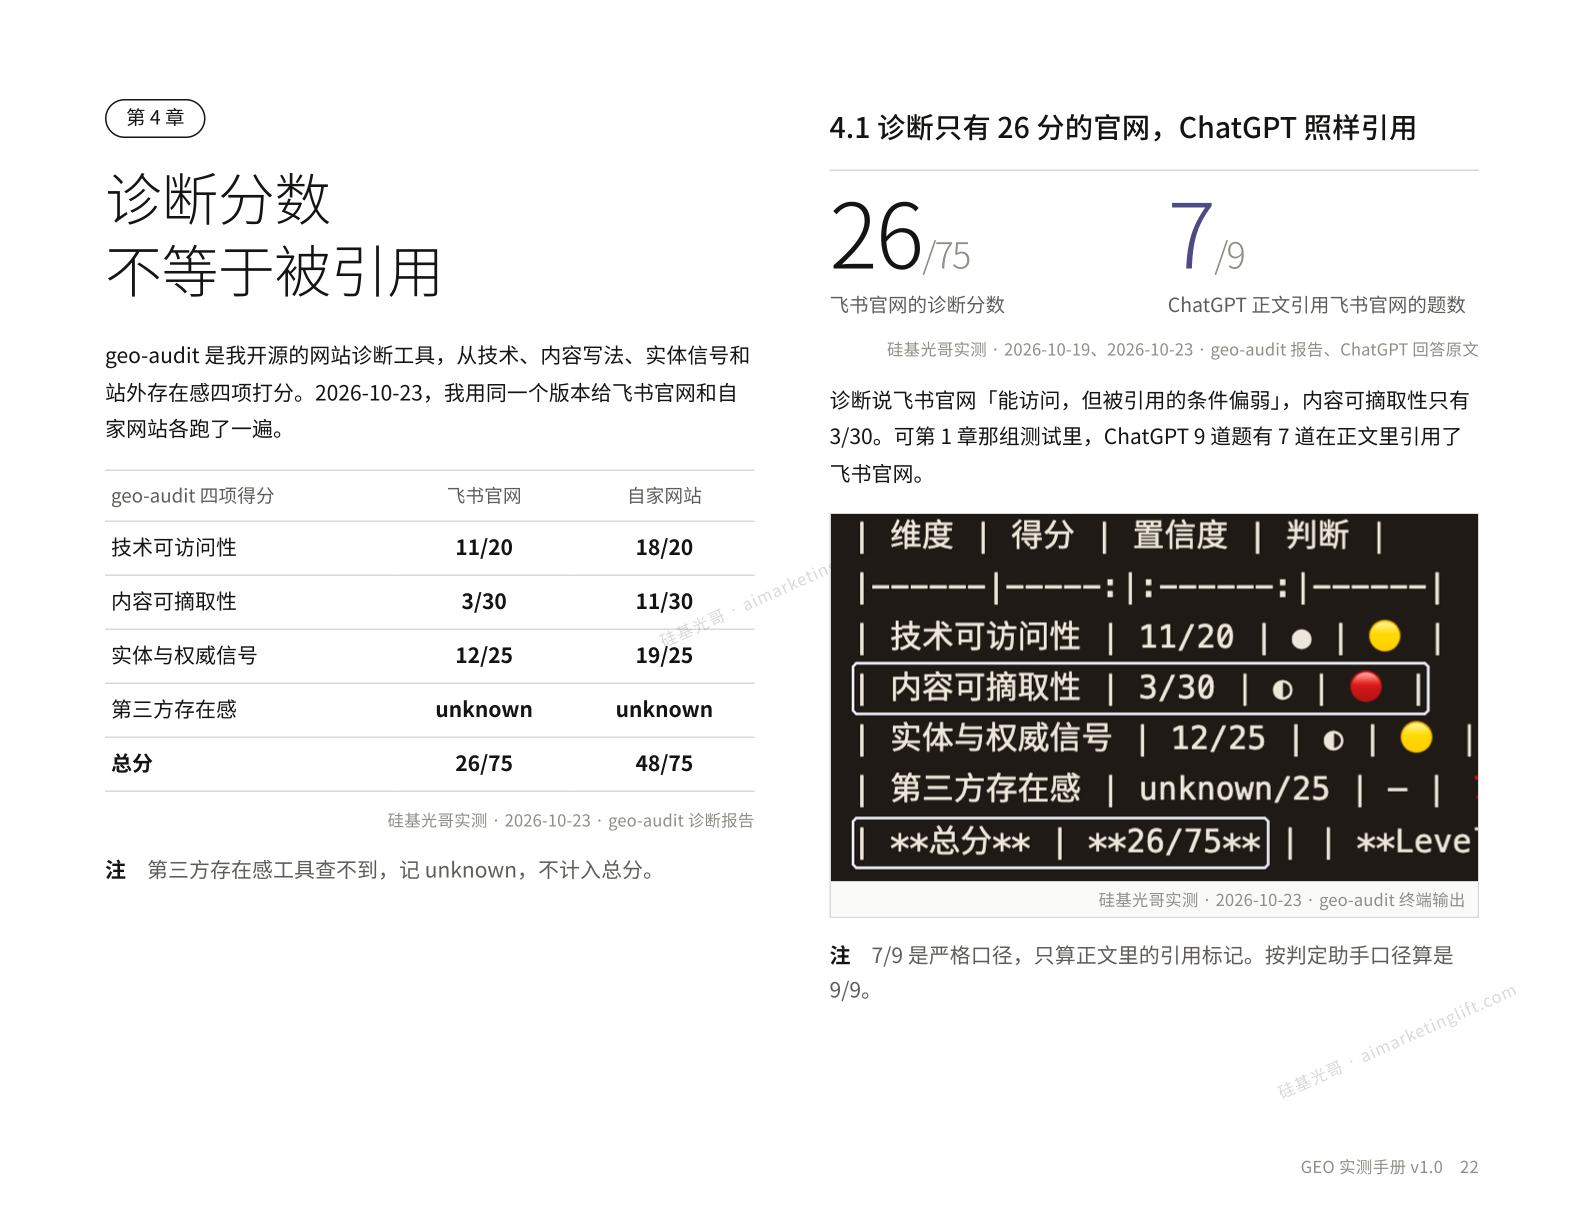
1. 诊断只有 26 分的官网,ChatGPT 照样 7/9 引用
我用自己开源的网站诊断工具 geo-audit(从技术可访问性、内容可摘取性、实体信号、第三方存在感四项打分)给飞书官网跑了一遍,总分只有 26/75。
因为飞书的版本对比页是由浏览器运行前端脚本后渲染出来的,工具直接抓下来的网页几乎是空的(H1: 0, H2: 0),导致“内容可摘取性”只有 3/30。
但回到 ChatGPT 的真实回答里,它不仅在 7/9 的题目里正文引用了飞书官网,还在回答中准确写出了版本对比页上“免费版最多 100 用户”的内容。工具抓到的,和 AI 实际读到的,不是同一份东西。
2. 网站这一层的真实优先级:什么先做,什么别花时间? 结合我自己的实测与 Google 搜索中心、Ahrefs、Search Engine Land 的统计数据,手册第 5 章排出了明确先后:
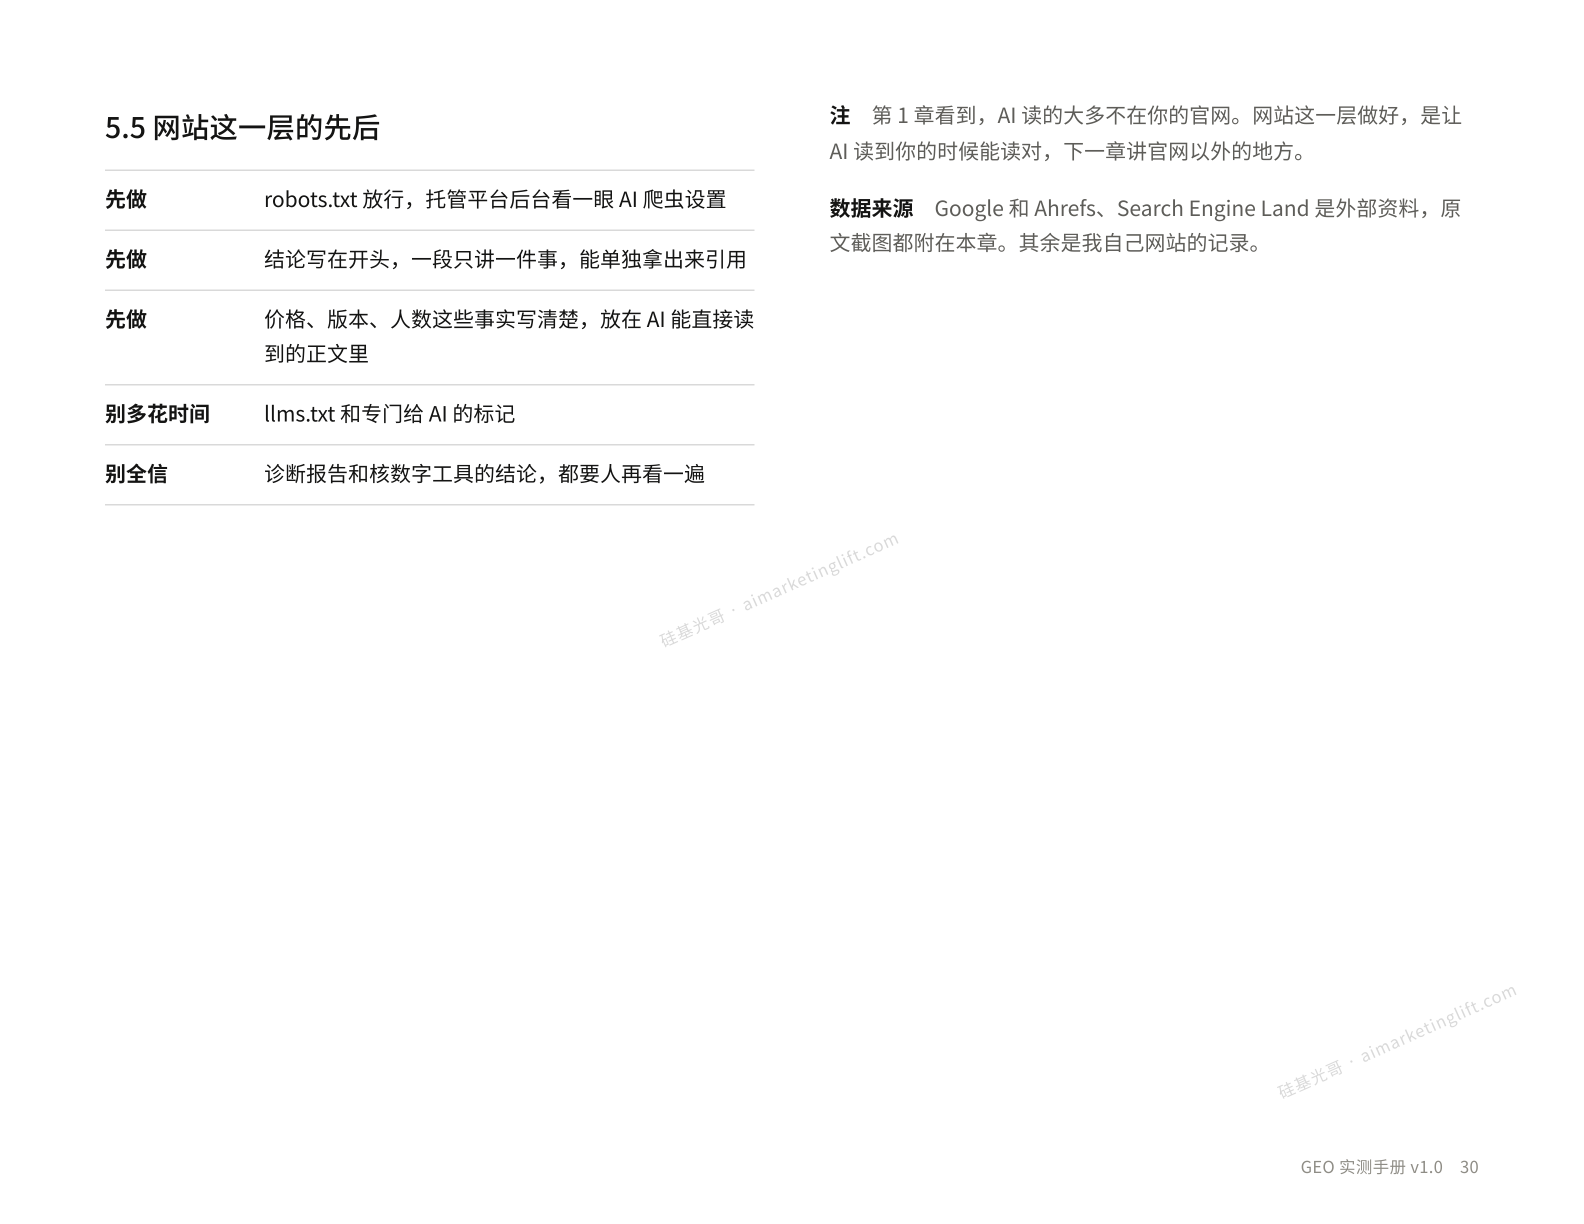
- 先做 1(放行真爬虫,过滤扫描器):
robots.txt放行,并去 Cloudflare 等托管平台后台确认 AI 爬虫开关。看爬虫日志时把被拦(4xx)和放行的分开,实测 Cloudflare 后台被拦的 144 个请求全是找.env密钥的扫描器,放行的那部分才代表 AI 真来读了哪些页。 - 先做 2(结论放进前 30%):Search Engine Land 报道的 18,012 条 ChatGPT 引用分析显示,44.2% 的引用来自页面前 30%,越往后越少。我自己那篇进 Google AI 概览第 1 张卡片的文章,也是第一屏就写清核心结论。
- 先做 3(核心事实人工核对):价格、版本、人数写进正文。若用 AI 辅助写对比稿,数字必须人工回原页面核对(实测豆包曾把腾讯云调用价当成产品订阅价,自动核数字脚本也查不出这种张冠李戴)。
- 别多花时间(
llms.txt作用有限):Google 指南明确表示不需要新建 AI 文本文件或特殊标记;Ahrefs 统计显示 97% 的llms.txt在 2026 年 5 月一次访问都没有。
04 拆解“归因与投喂玄学”:被引用后怎么量?哪些红线不能碰?
1. 被引用了 ≠ 有人点进来,归因必须分开算 在我的网站实测中(2026-09-16 至 2026-10-14),Bing Webmaster Tools 的 AI Performance 报告显示页面被 Copilot 引用了 175 次,但同期 GA4 后台里来自 Copilot 的访问会话是 0 次。而 ChatGPT 带来的 26 次访问里,有 21 次高度扎堆在 8 月 11 日至 14 日这四天。
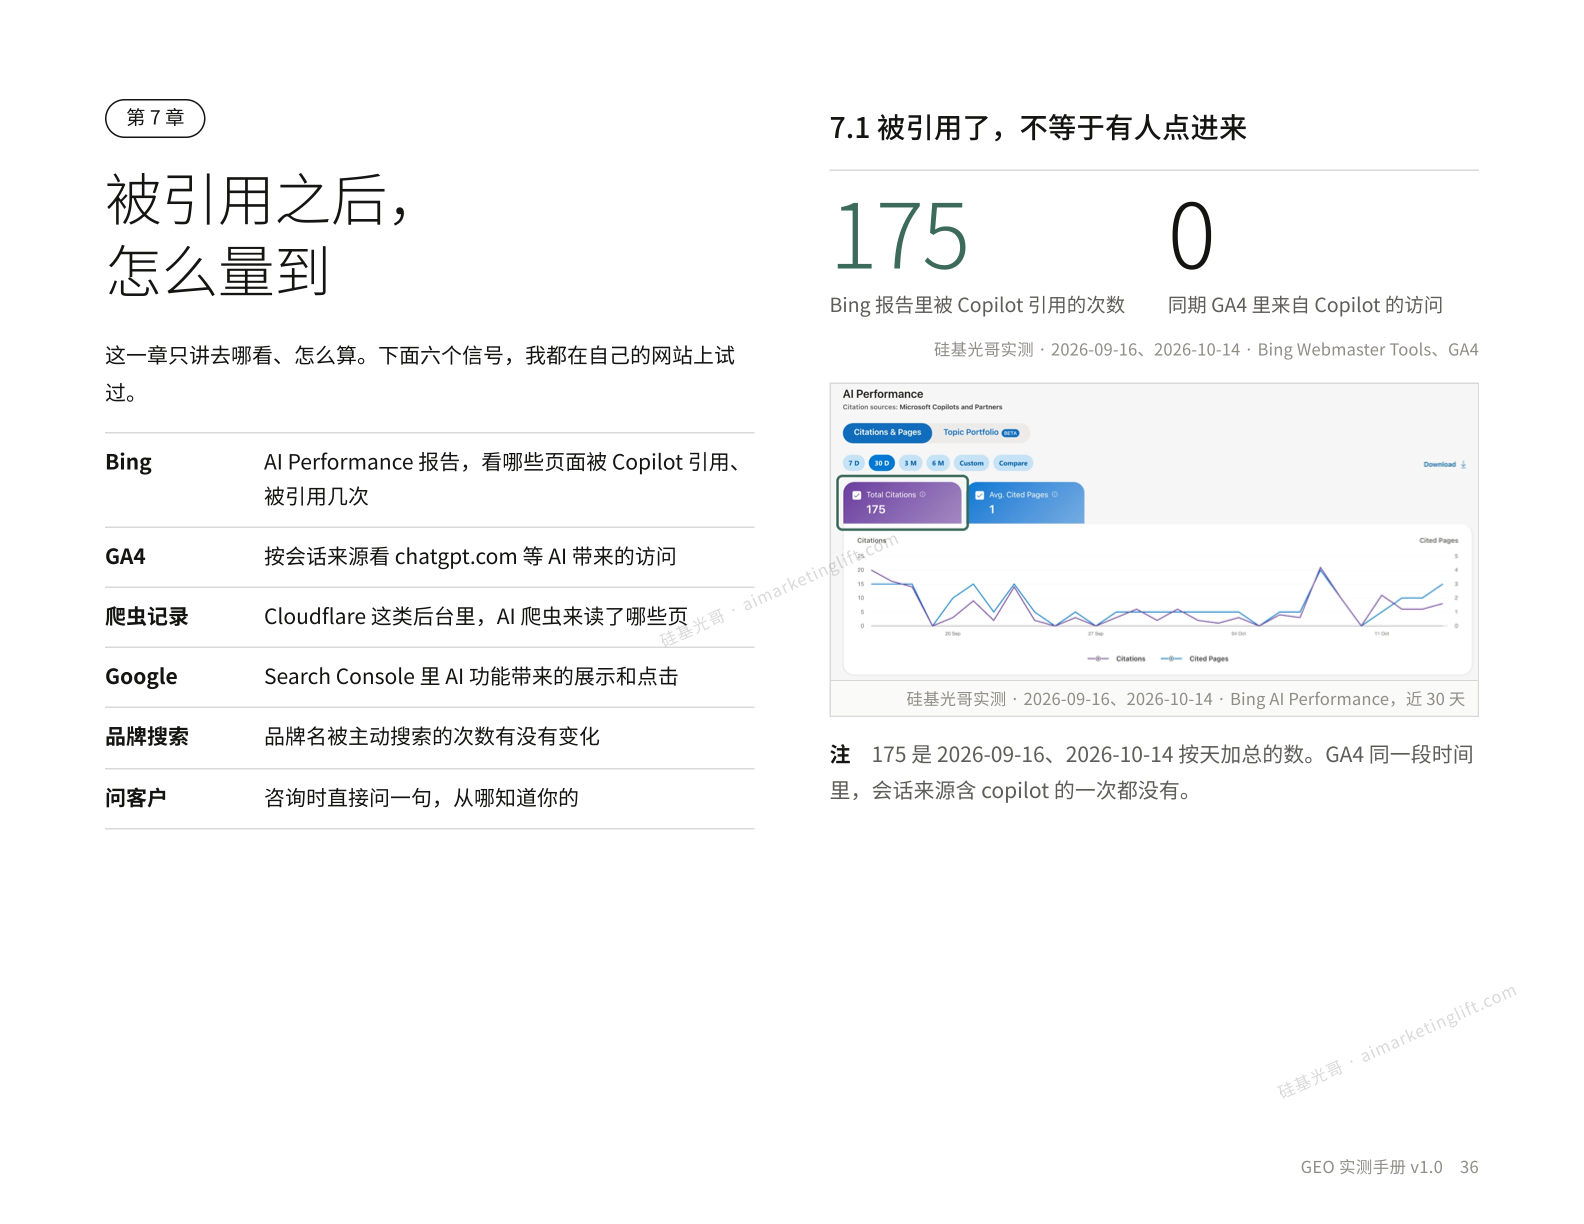
手册第 7 章给出了 量化归因的 4 条操作铁律:
- 分开算:被引用(看 Bing AI Performance / GSC)和带来访问(看 GA4 会话来源)是两件事,各看各的报告;
- 写清口径:GA4 的“来源汇总表”与“按日期导出表”会有细微次数差异,汇报时写明出自哪张表、哪段日期;
- 按月存档:标准 GA4 的探索明细保留期默认可能只有 2 个月,务必检查设置并按月导出备份;
- 回原表核:让 AI 帮忙读后台导出表时,算出来的数字一定要抽几个回原始 CSV 表核对。
2. 编造数据投喂 AI 已被罚 12 万,行业标准与平台政策已划出红线 复旦大学一篇分析 17,211 条 AI 引用的论文发现,花 14 美元买一次发稿服务,发出 13 篇稿子,1 小时内就有 AI 搜索引用。往 AI 里塞内容门槛很低,但能做到,绝不等于可以做:
- 3 起市场监管行政处罚:今年 6 月北京朝阳区(虚构评分 99.6 分、市占率 49%,罚款 5 万元)、9 月广州越秀区(为律所批量生成 TOP5 排行榜,虚构 187 起案件和满意度评分,罚款 12 万元)及深圳均已通报处罚,监管部门明确认定此类行为干扰了 AI 搜索产品的正常运行。
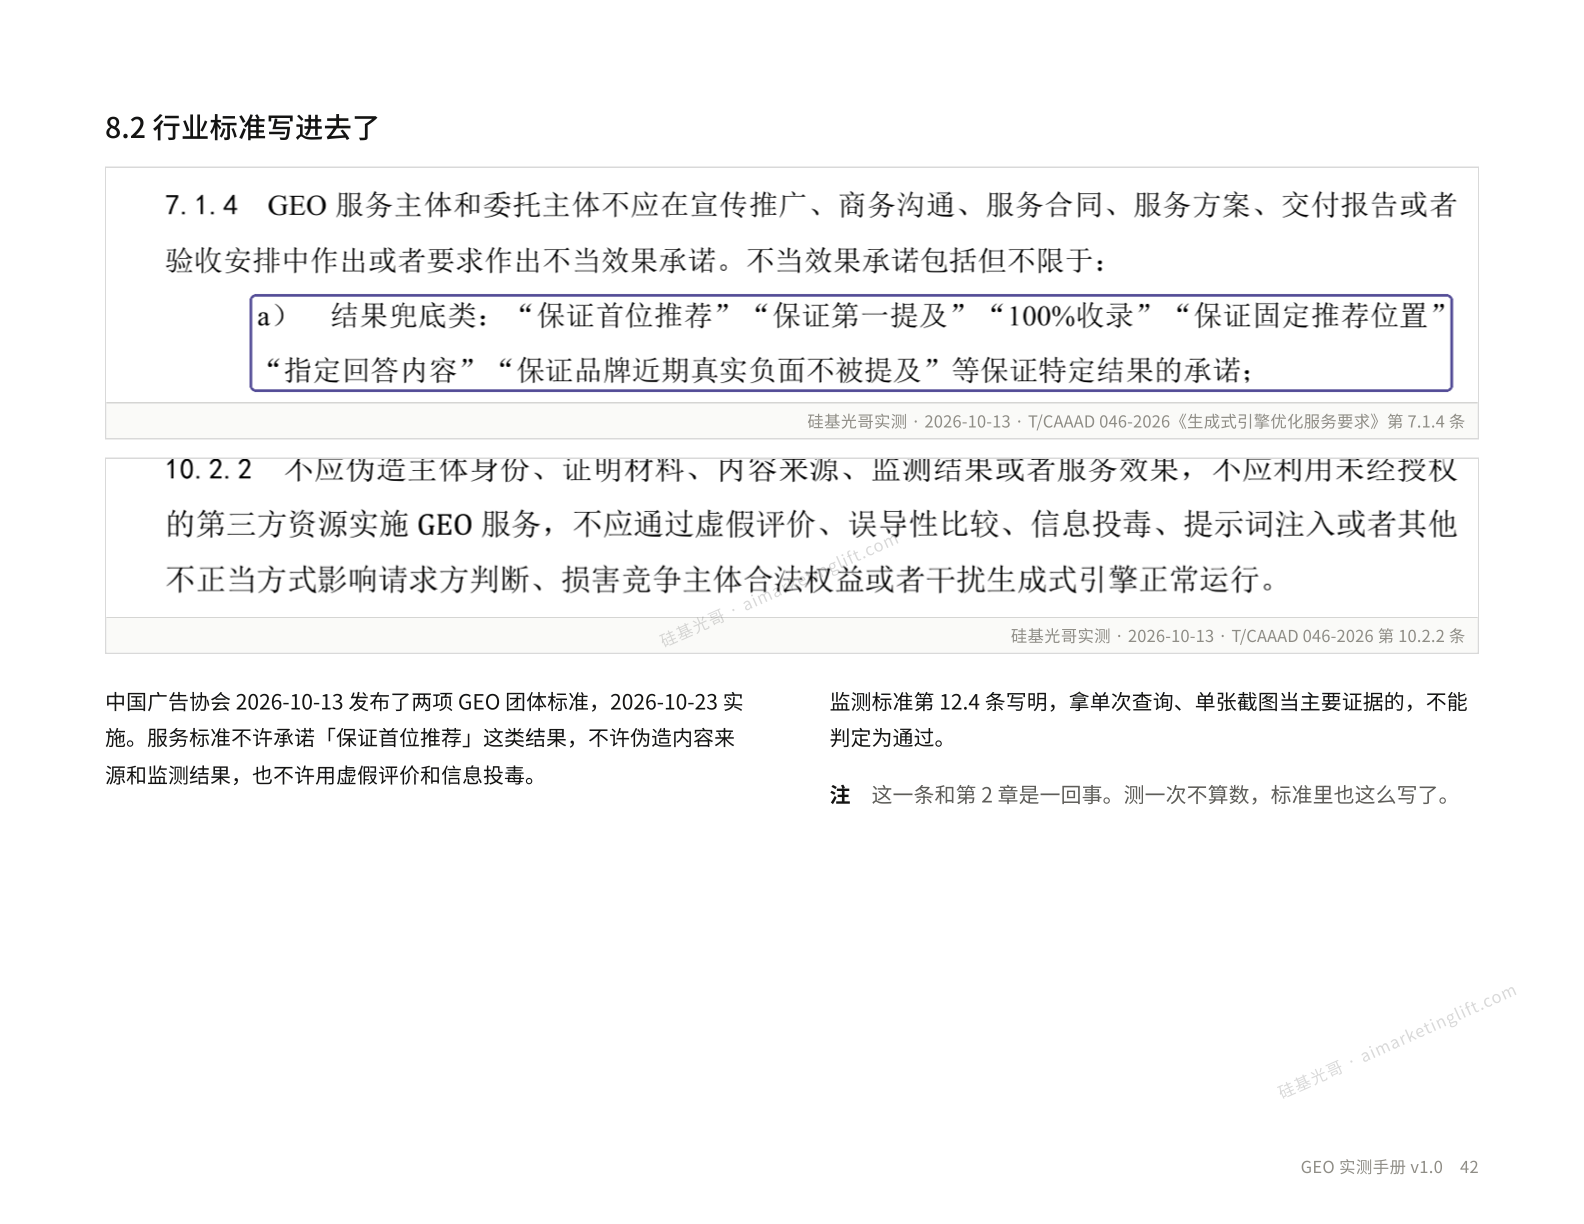
- 中广协 GEO 团体标准已实施:中国广告协会 2026 年 10 月发布并实施了两项 GEO 团标(
T/CAAAD 046-2026),明确禁止承诺“保证首位推荐”“100%收录”,禁止伪造信源与虚假评价;且第 12.4 条明确写明:拿单次查询、单张截图当主要证据的,不能判定为通过。 - AI 平台政策同步收紧:Anthropic 将于 2026-11-12 生效的使用政策也明确禁止用一批假装互不相关、实则互相印证的网站去操纵 AI 读取的信源。
05 这本 50 页手册里,还有哪些拿来即用的基建?
除了上述 8 个章节的完整实测数据与截图,手册最后还提供了 3 个直接抄作业的实操附录:
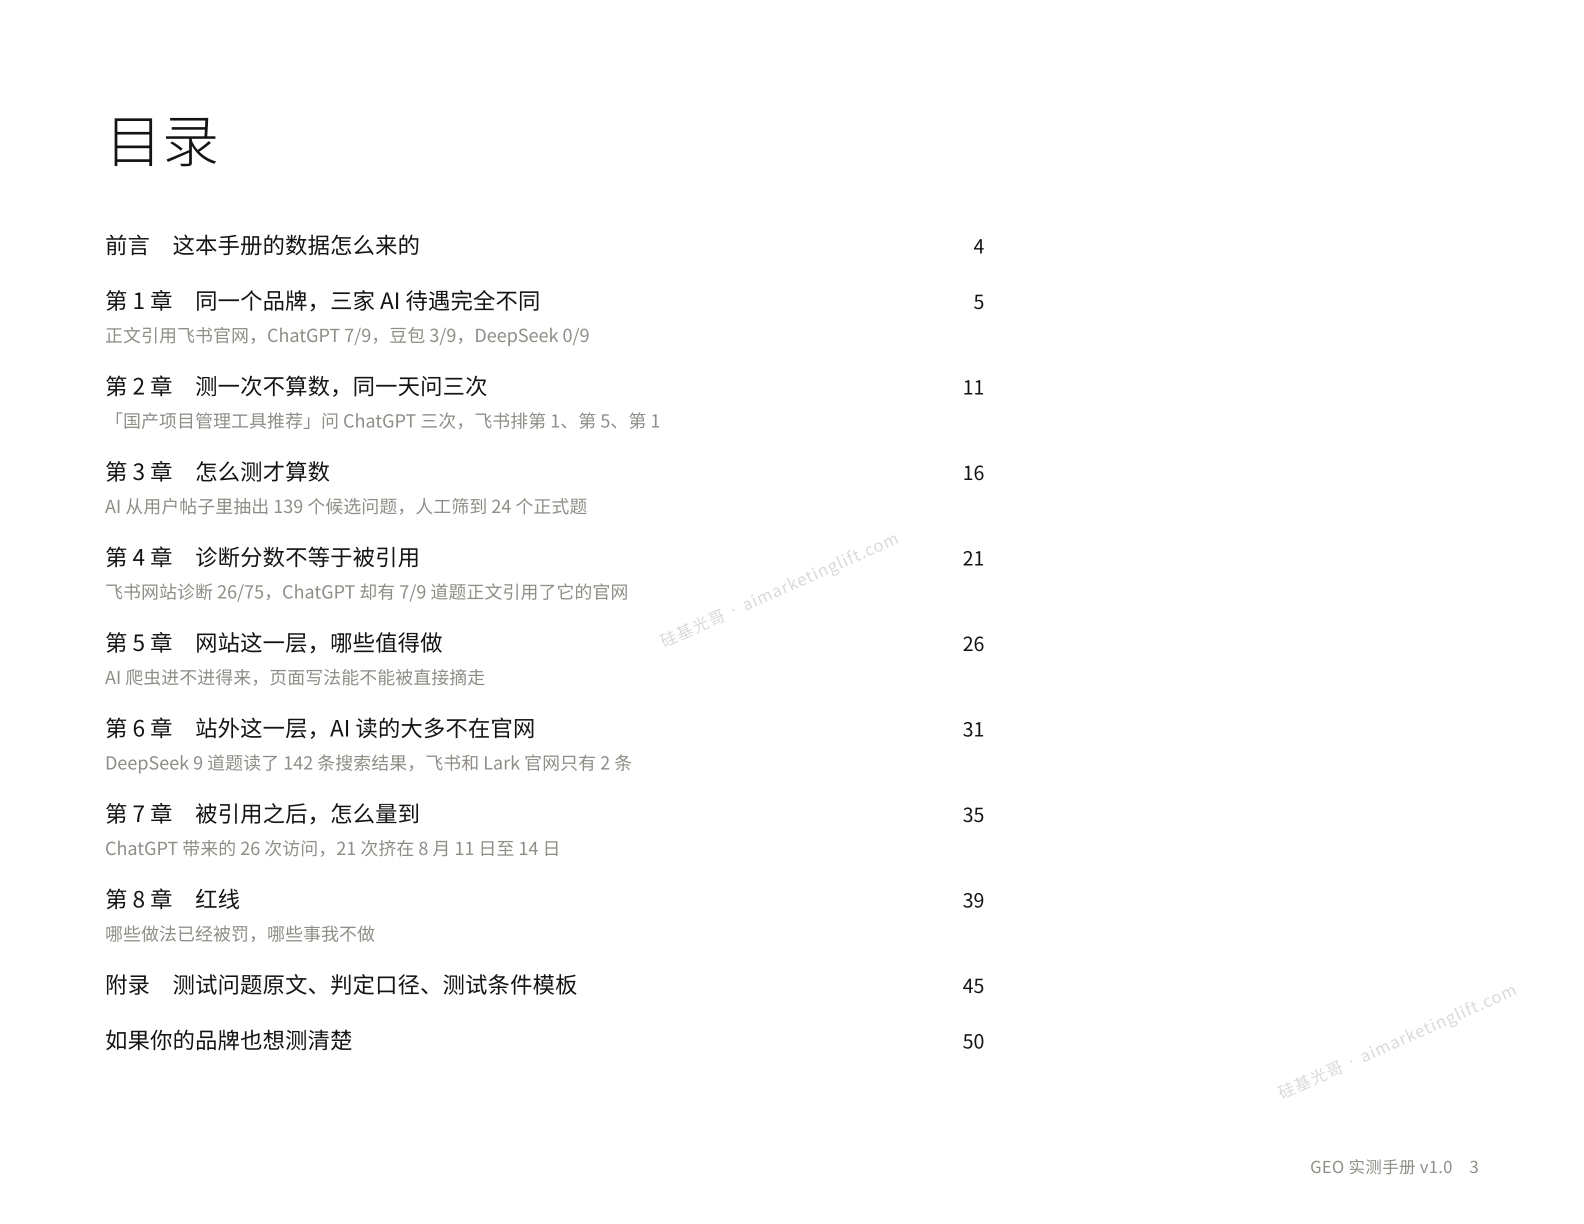
- 附录 A|测试问题原文库:一字不差附上飞书 A 组 9 题、同日复测 3 题、以及人工筛出的 24 道正式题库原文与出处。
- 附录 B|可见度判定口径表:清晰界定“正文提及、仅被引、仅检索到、无引用数据、未出现”五级判定逻辑与两把尺子的算法差异。
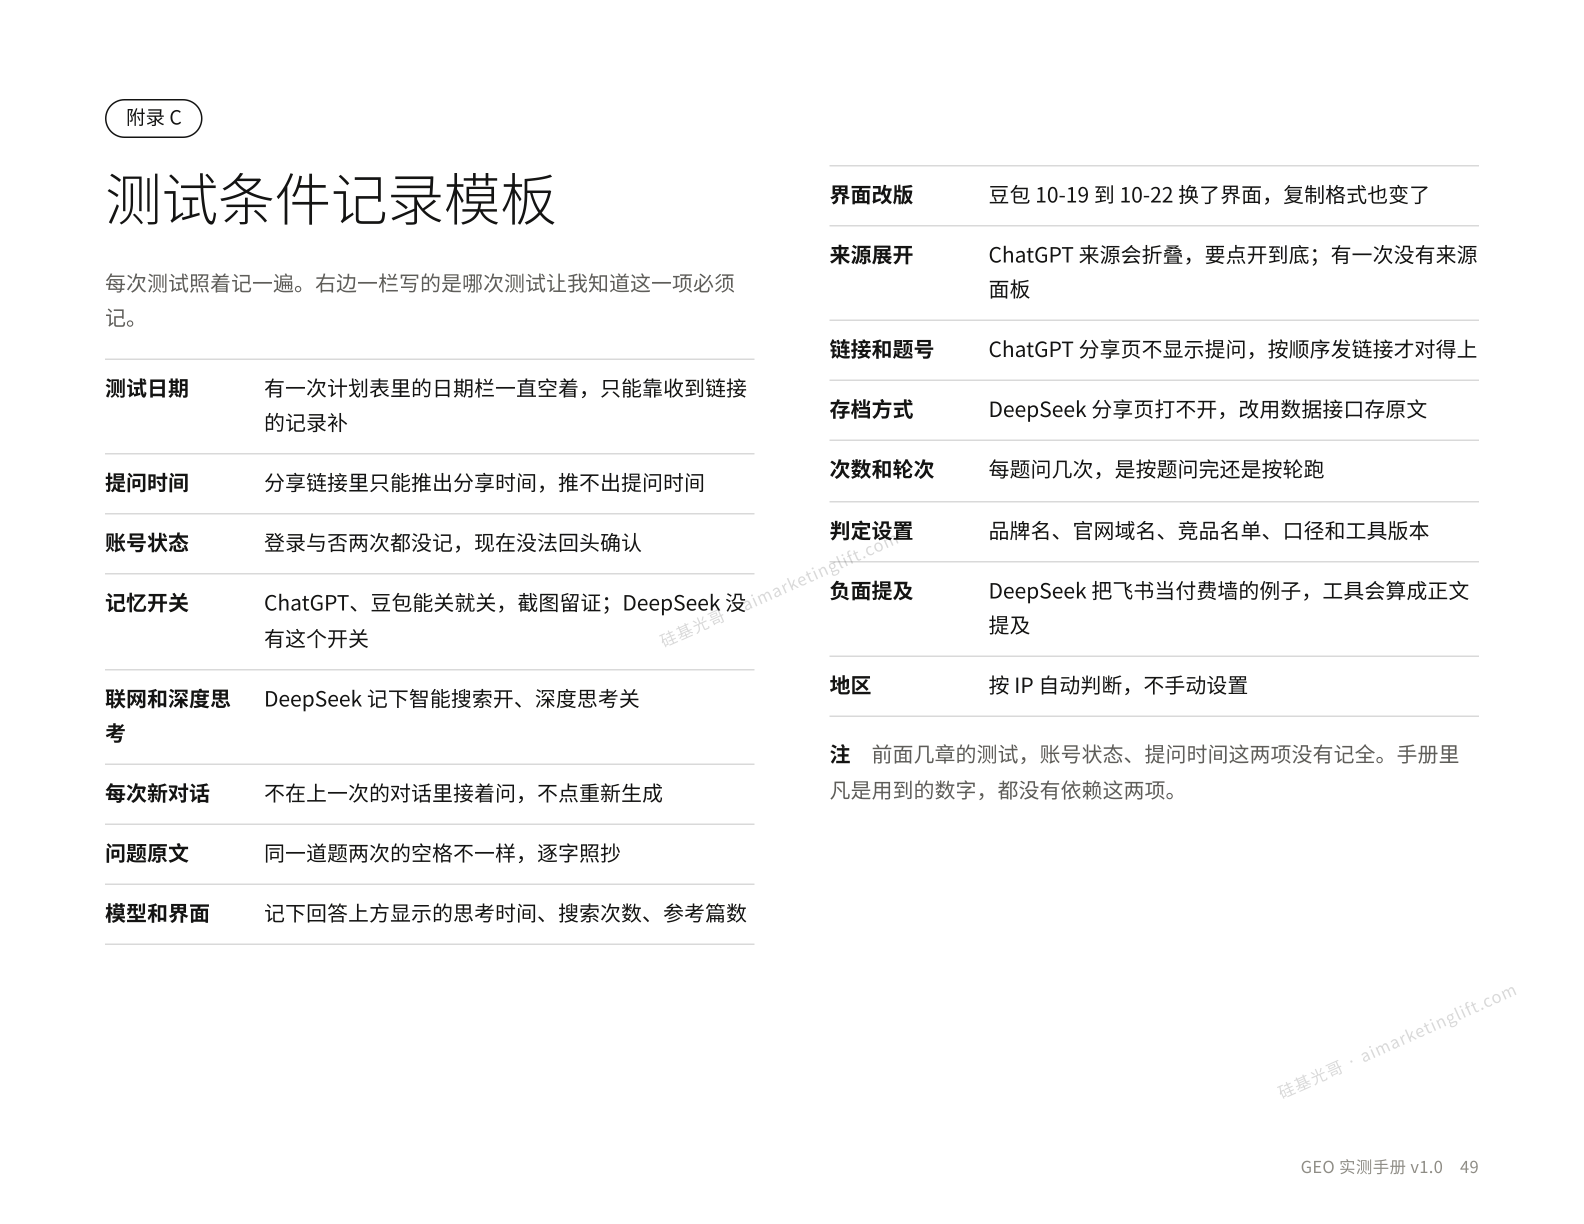
- 附录 C|15 项测试条件记录模板:每次测试照表记一遍(测试日期、提问时间、账号状态、记忆开关、联网与深度思考开关、每次新对话、界面改版、来源展开等),右边一栏直接写明了“哪次踩坑让我知道这一项必须记”。
06 免费获取完整 PDF 与配套开源工具
《GEO 实测手册:AI 到底怎么推荐一个品牌》(v1.0,50 页横版 PDF)按 CC BY-NC-ND 4.0 授权发布:
- 可以 免费转发、分享整本手册;
- 可以 引用里面的数字和截图(请署名「硅基光哥」)。
📥 完整手册获取方式:
- 点击以下链接打开(横版 PDF,建议在电脑端打开阅读体验最佳):
- 配套开源工具(均在 GitHub 的
jiguang9主页下开源):- geo-judge:GEO 可见度判定助手(贴入 AI 回答,自动判定品牌提及与官网引用状态)
- geo-audit:GEO 网站诊断工具,检查网站技术与结构,输出待办清单