7 月我写过一篇,提醒大家 Cloudflare 后台有个默认开着的小开关,会悄悄替你拒绝 AI 学习你的网站内容。
9 月 15 日,Cloudflare 把这块设置改了。那个小开关没了,自查的地方也换了。我对照 Cloudflare 的官方说明,又在自己网站的后台一项项点过,把新的情况和设置步骤整理在这里,每一步都配了截图。
一、这次改了什么
以前,Cloudflare 有一个"托管 robots.txt"的开关,默认开着。开着它,Cloudflare 就会在你网站的 robots.txt 里写一句"不许拿去训练 AI",很多人根本不知道。
robots.txt 是网站根目录下的一个小文件,专门写给各种爬虫看,告诉它们哪些能抓、哪些不能抓。
现在这个开关取消了,换成后台的三个下拉框。你在下拉框里选什么,Cloudflare 就照着做。想让它顺手把你的选择写进 robots.txt,再打开一个叫"自动程序偏好同步"的开关就行。
二、三个下拉框分别管什么
三个下拉框分别叫"搜索""代理""训练",对应三种来访的 AI 爬虫。
"搜索"管的是搜索引擎的爬虫。它把你的网页收进搜索结果,别人才搜得到你。
"代理"管的是 AI 替用户临时来查资料。比如有人问 ChatGPT"某某工具好不好用",ChatGPT 当场来翻你的网页,读完再回答他。
"训练"管的是 AI 公司来收集学习材料。你的内容被学进去,以后的新模型就天生知道你。想让 AI 推荐你的品牌,这一项最好放行。
三、新网站默认是什么
新网站接入 Cloudflare 时,会被问一句"这个域名上有没有靠广告挣钱的页面"。你怎么回答,决定了三个下拉框的默认值。
| 下拉框 | 回答"没有广告" | 回答"有广告" |
|---|---|---|
| 搜索 | 允许 | 允许 |
| 代理 | 允许 | 在有广告的页面上阻止 |
| 训练 | 允许 | 禁止 |
没广告的网站,三项默认全部放行,不用改。
挂了广告的要留意。很多营销站、博客也挂 AdSense,只是想赚点服务器钱,网站主要还是用来获客。这种情况,接入以后要手动把"代理"和"训练"改回"允许(不阻止)"。
四、老网站要自己看一眼
9 月 15 日以前就接入 Cloudflare 的老网站,Cloudflare 基本照搬了原来的设置。
当初保持默认、一直没动过的老站,现在"训练"多半还是"禁止",也就是还在拒绝 AI 学习。7 月那篇提醒的问题,在这些网站上还在,只是改的地方换了,按下面第六节的步骤改就行。
五、最容易选错的地方,"阻止"和"禁止"
点开"训练"的下拉框,会看到四个选项,阻止、在有广告的页面上阻止、禁止、允许(不阻止)。
"阻止"和"禁止"在中文里差不多一个意思,在这里差得很远。
"阻止"相当于在门口把人拦下。9 月 15 日以后,它连 Google、Bing 的搜索爬虫也一起拦,你的网站可能从搜索结果里慢慢消失。AI 搜索挑引用来源时,也很看重网站原来的搜索排名,搜索一丢,AI 那边也跟着受影响。
"禁止"相当于在门口挂一块牌子,上面写着"可以进来看,别拿去训练 AI"。搜索爬虫照常进来,排名不受影响。
所以只想拒绝 AI 学习,选"禁止",别选"阻止"。
还有一个例外。微软要到 2027 年初才认这块牌子,在那之前,选"禁止"也拦不住 Bing 拿内容去训练。
六、手把手设置
第 1 步,打开设置页
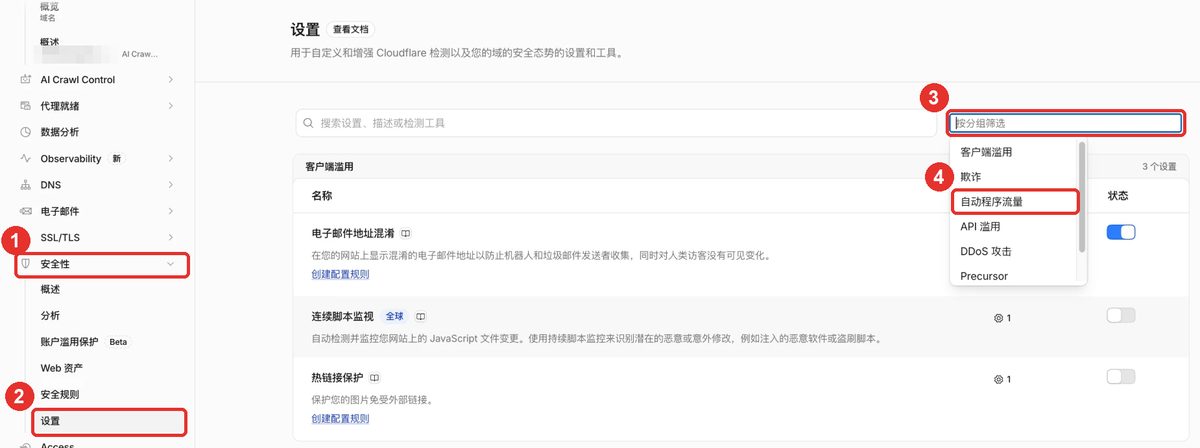
登录 Cloudflare,点进你的域名。在左侧菜单点"安全性"①,再点它下面的"设置"②。然后点页面右上角的"按分组筛选"③,选"自动程序流量"④。
第 2 步,打开 AI 设置
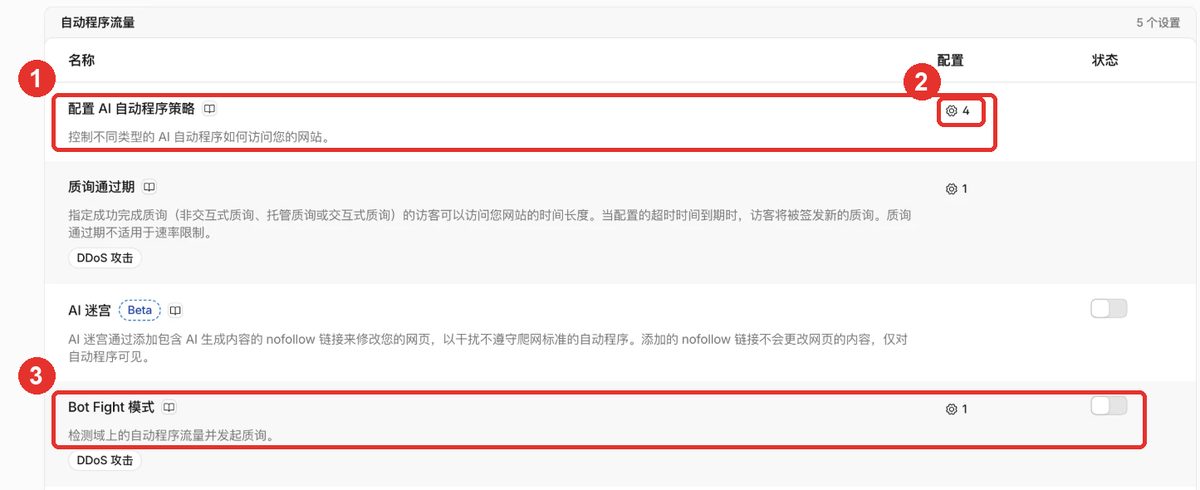
列表第一行就是"配置 AI 自动程序策略"①,点它右边的齿轮图标②。
顺便看一眼下面的"Bot Fight 模式"③。这个开关打开后,Cloudflare 会把它认为是机器的访问都拦下来盘问一遍,AI 爬虫也可能被挡在外面。想让 AI 读到你的网站,这个开关保持关闭。
第 3 步,选好三个下拉框
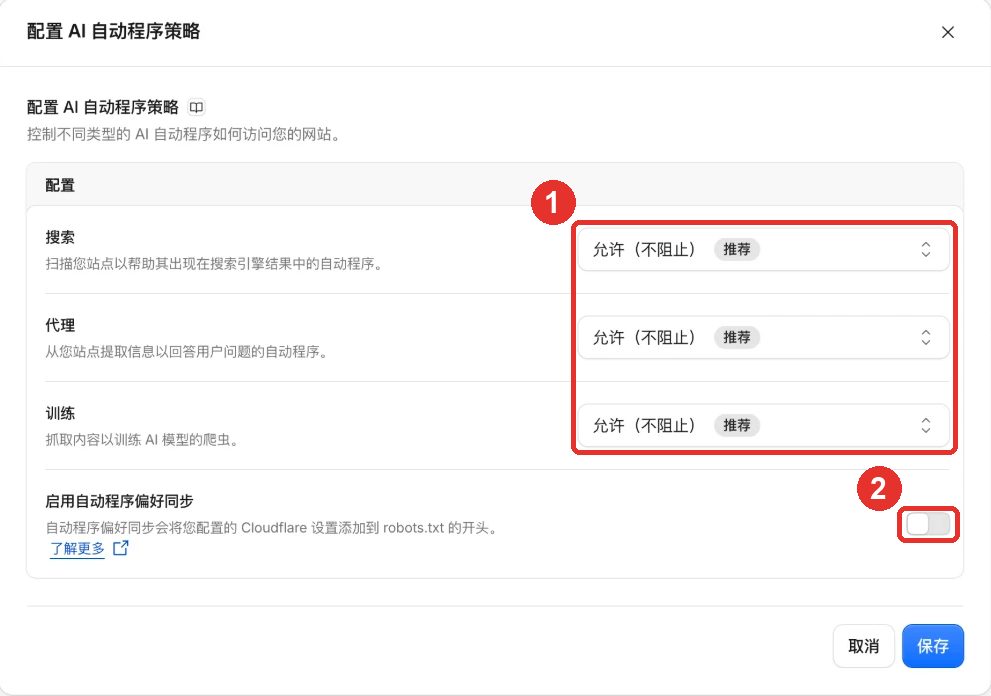
弹出的窗口里就是前面说的三个下拉框①。想让 AI 看到你、记住你,三项都选"允许(不阻止)",这也是 Cloudflare 标了"推荐"的选项。
下面的"启用自动程序偏好同步"②,开着的话,Cloudflare 会把你的选择自动写进 robots.txt 的开头。你自己写过 robots.txt,里面有特别的规则,就关掉它,自己管。没写过的,开着也行。
选好以后点右下角"保存"。
第 4 步,只想拒绝 AI 学习时这样选
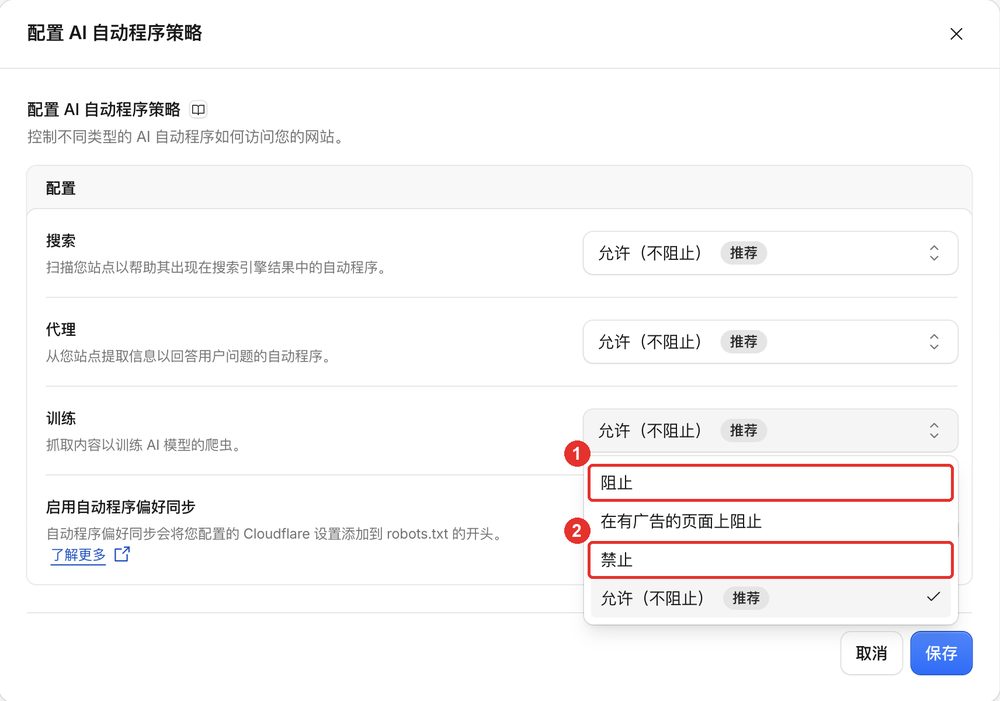
付费课程、独家报告这类卖钱的内容,不想给 AI 拿去学,就点开"训练"的下拉框。别选"阻止"①,它会把 Google 搜索也一起挡掉。选"禁止"②,只拒绝训练,搜索照常。
七、改完怎么确认
在浏览器地址栏输入 你的域名/robots.txt,打开以后按 Ctrl+F(Mac 是 Command+F)搜两个词,ai-train 和 GPTBot。
想让 AI 学习的网站,如果看到 ai-train=no,或者 GPTBot 后面跟着 Disallow: /,说明还在拒绝 AI,回到第 3 步检查"训练"那一项。改完再刷新一次 robots.txt,确认内容跟着变了。
robots.txt 只是一块告示牌,Cloudflare 自己也写明不保证爬虫都会听。OpenAI、Google、Anthropic 这些大公司会照着做,不守规矩的爬虫照样乱抓。想看 AI 爬虫到底有没有来,可以点左侧菜单的"AI Crawl Control",里面有各家爬虫的访问记录。
八、该拦还是该放
就看一条,你的内容本身卖钱,还是用来让人找到你。
付费课程、独家研报、原创小说这类本身卖钱的内容,"训练"选"禁止",完全合理。凭什么免费给大模型当教材?
营销站、博客、产品官网、工具站,网站本来就是为了被人找到,三项都放行。
过去二十年,网站看的是 Google 排名。往后,用户越来越多地直接问 AI"该买哪个、该用哪个",模型记不记得你,也开始要紧了。这件事从后台那三个下拉框就开始了。
关于 AI 爬虫为什么值得认真对待,还可以看AI 爬虫来我网站狂吃 404 的排查实录。