很多人一做 GEO,就先让 AI 生成几百个问题,再围绕这些问题批量写文章。
内容很快就铺出去了,可过一段时间回头看,你会发现几个麻烦。
客户可能根本没有问过这些问题。文章有没有被 ChatGPT、Perplexity 或 Google AI 引用,也没有测试记录。即使后来多了访问和询盘,你也很难判断它们和这批内容有什么关系。
最后做了很多内容,却说不清内容从哪里来,也不知道下一步应该改什么。
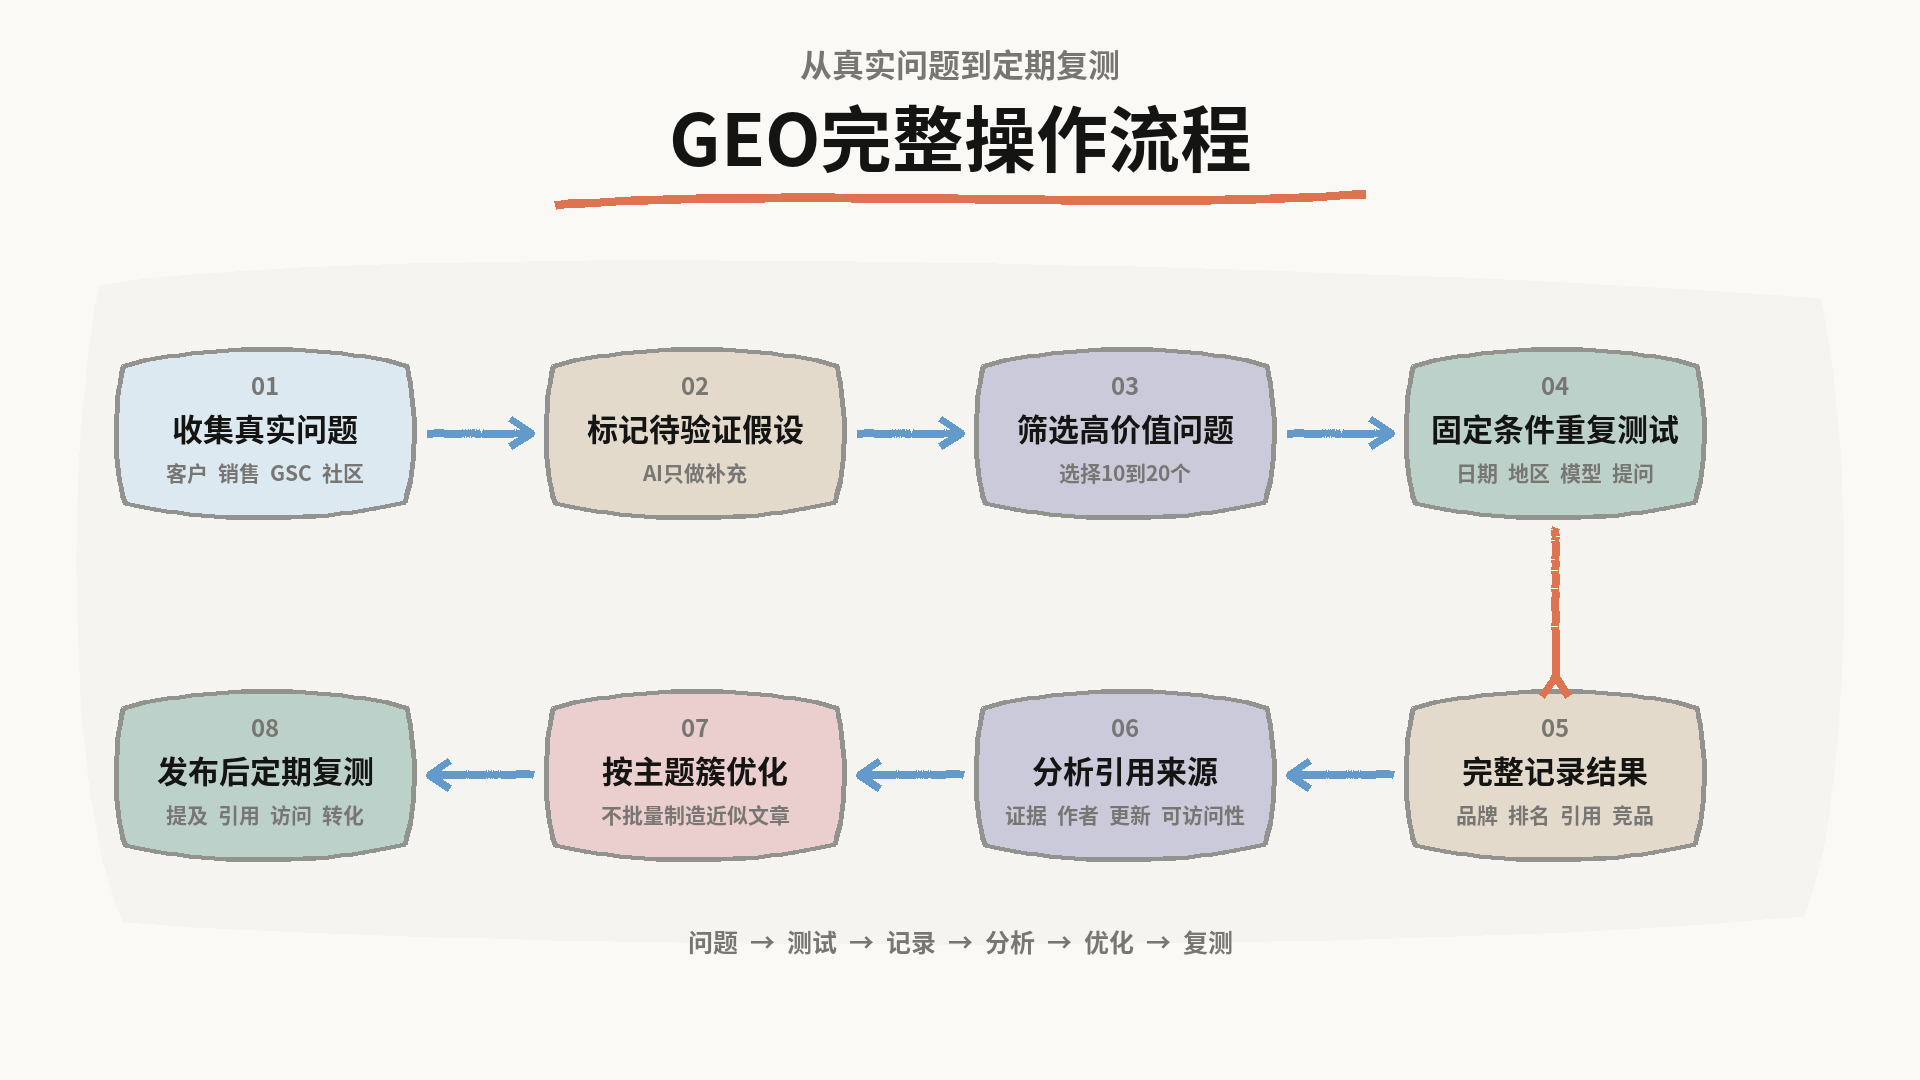
一套更可靠的 GEO 流程,应该从真实问题开始,完整走完一遍是下面这样。
一、从真实问题开始
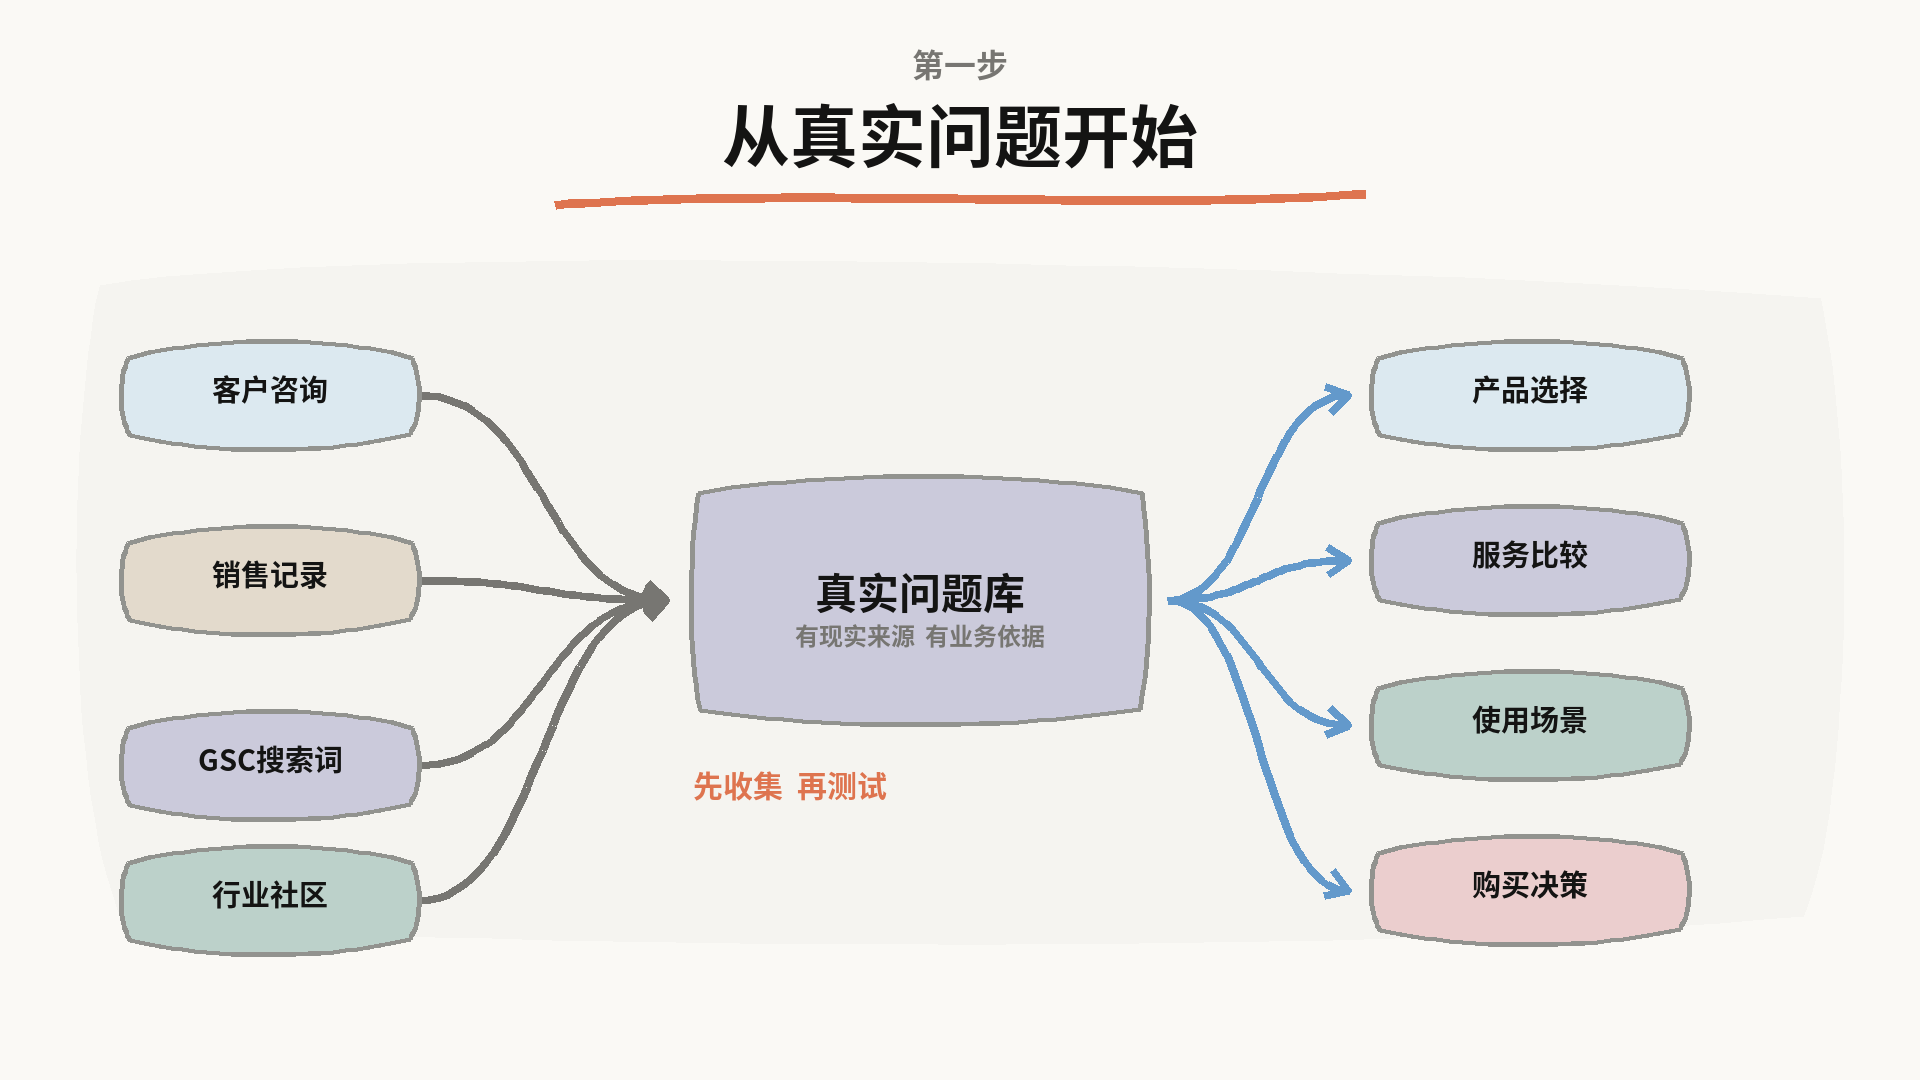
先从客户咨询、销售记录、GSC 搜索词和行业社区中收集问题。
整理用户真实问过什么,购买前担心什么,销售经常需要解释什么。GSC 可以帮助我们找到用户已经搜索过的词,社区讨论则能补充一些还没有进入网站的数据。
这些问题出现过,后面的测试才有现实依据。
二、AI 补充的是待验证假设
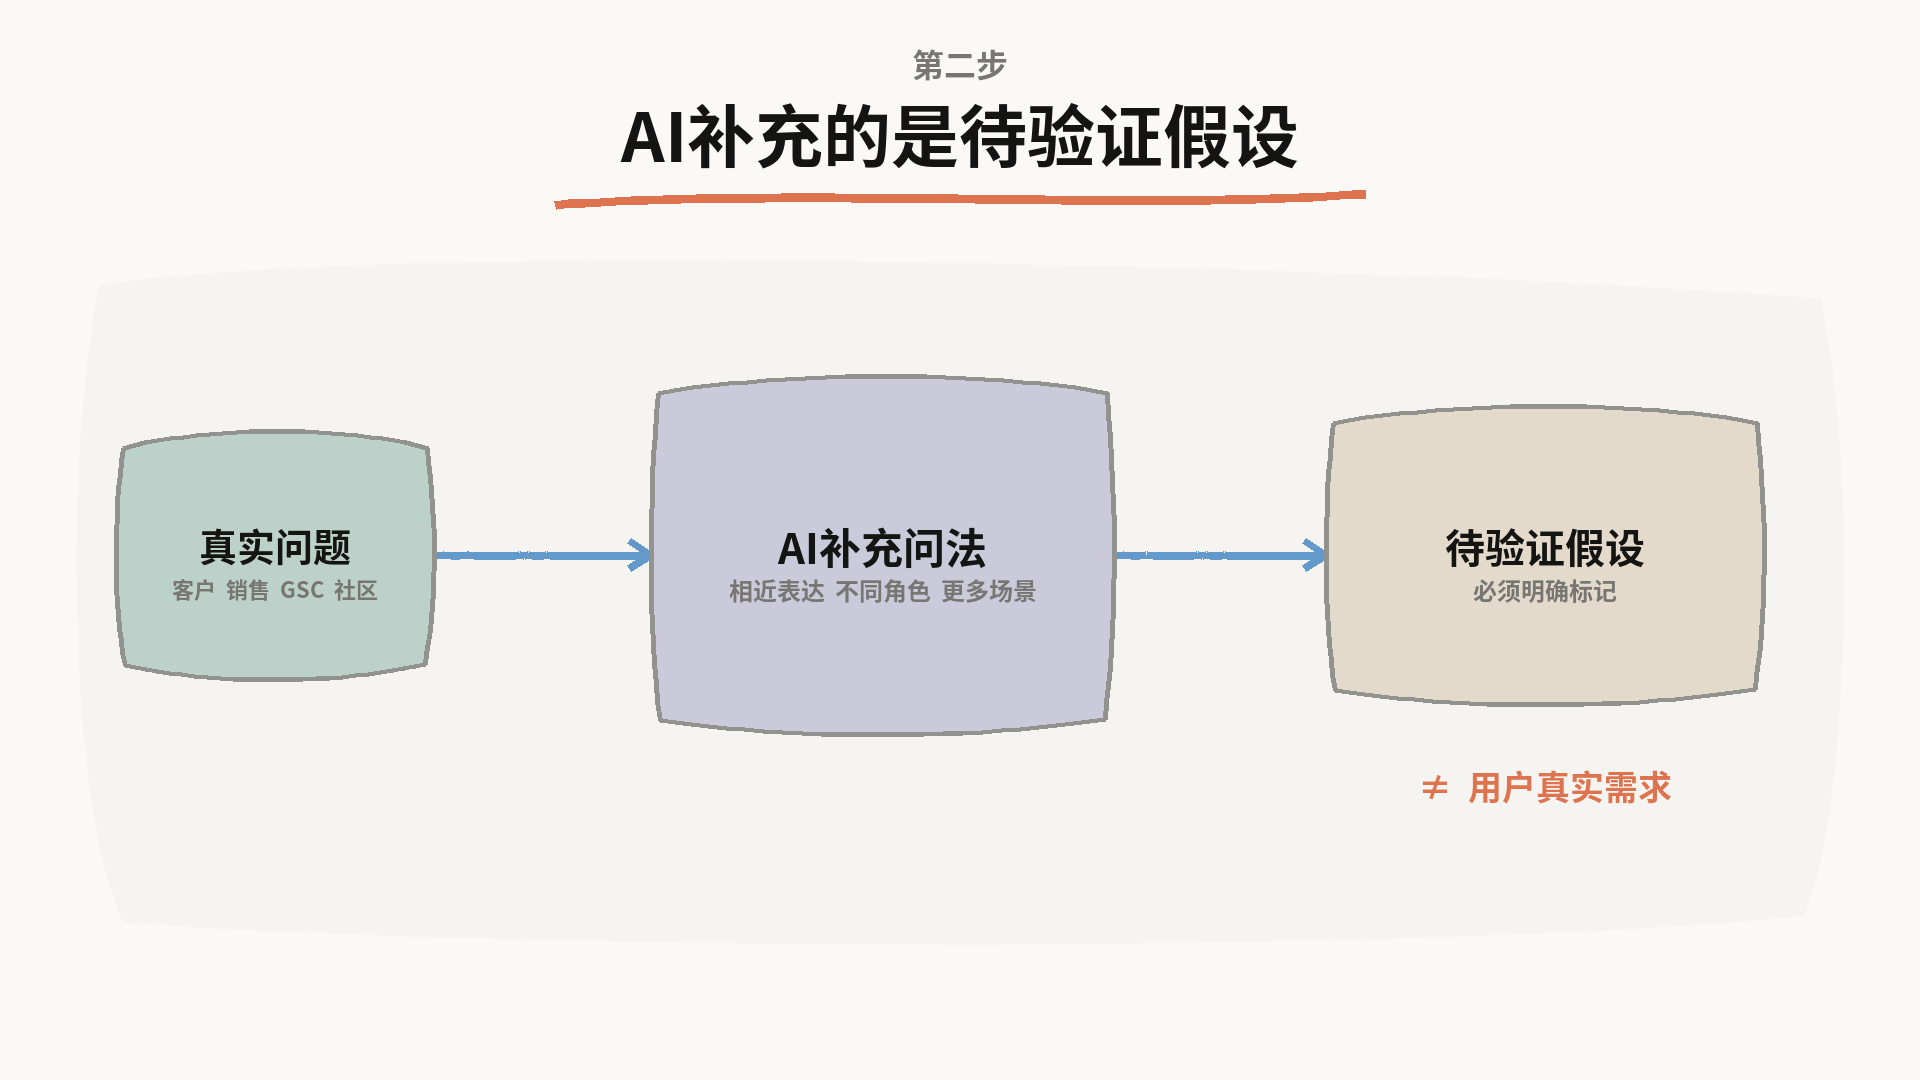
AI 可以帮助我们扩展相近的问法,补充不同角色可能关注的内容。
不过,这些问题要明确标记为待验证假设。它们暂时只能作为候选,不能直接当成用户需求,更不能马上拿去批量生产文章。
三、筛选十到二十个高价值问题
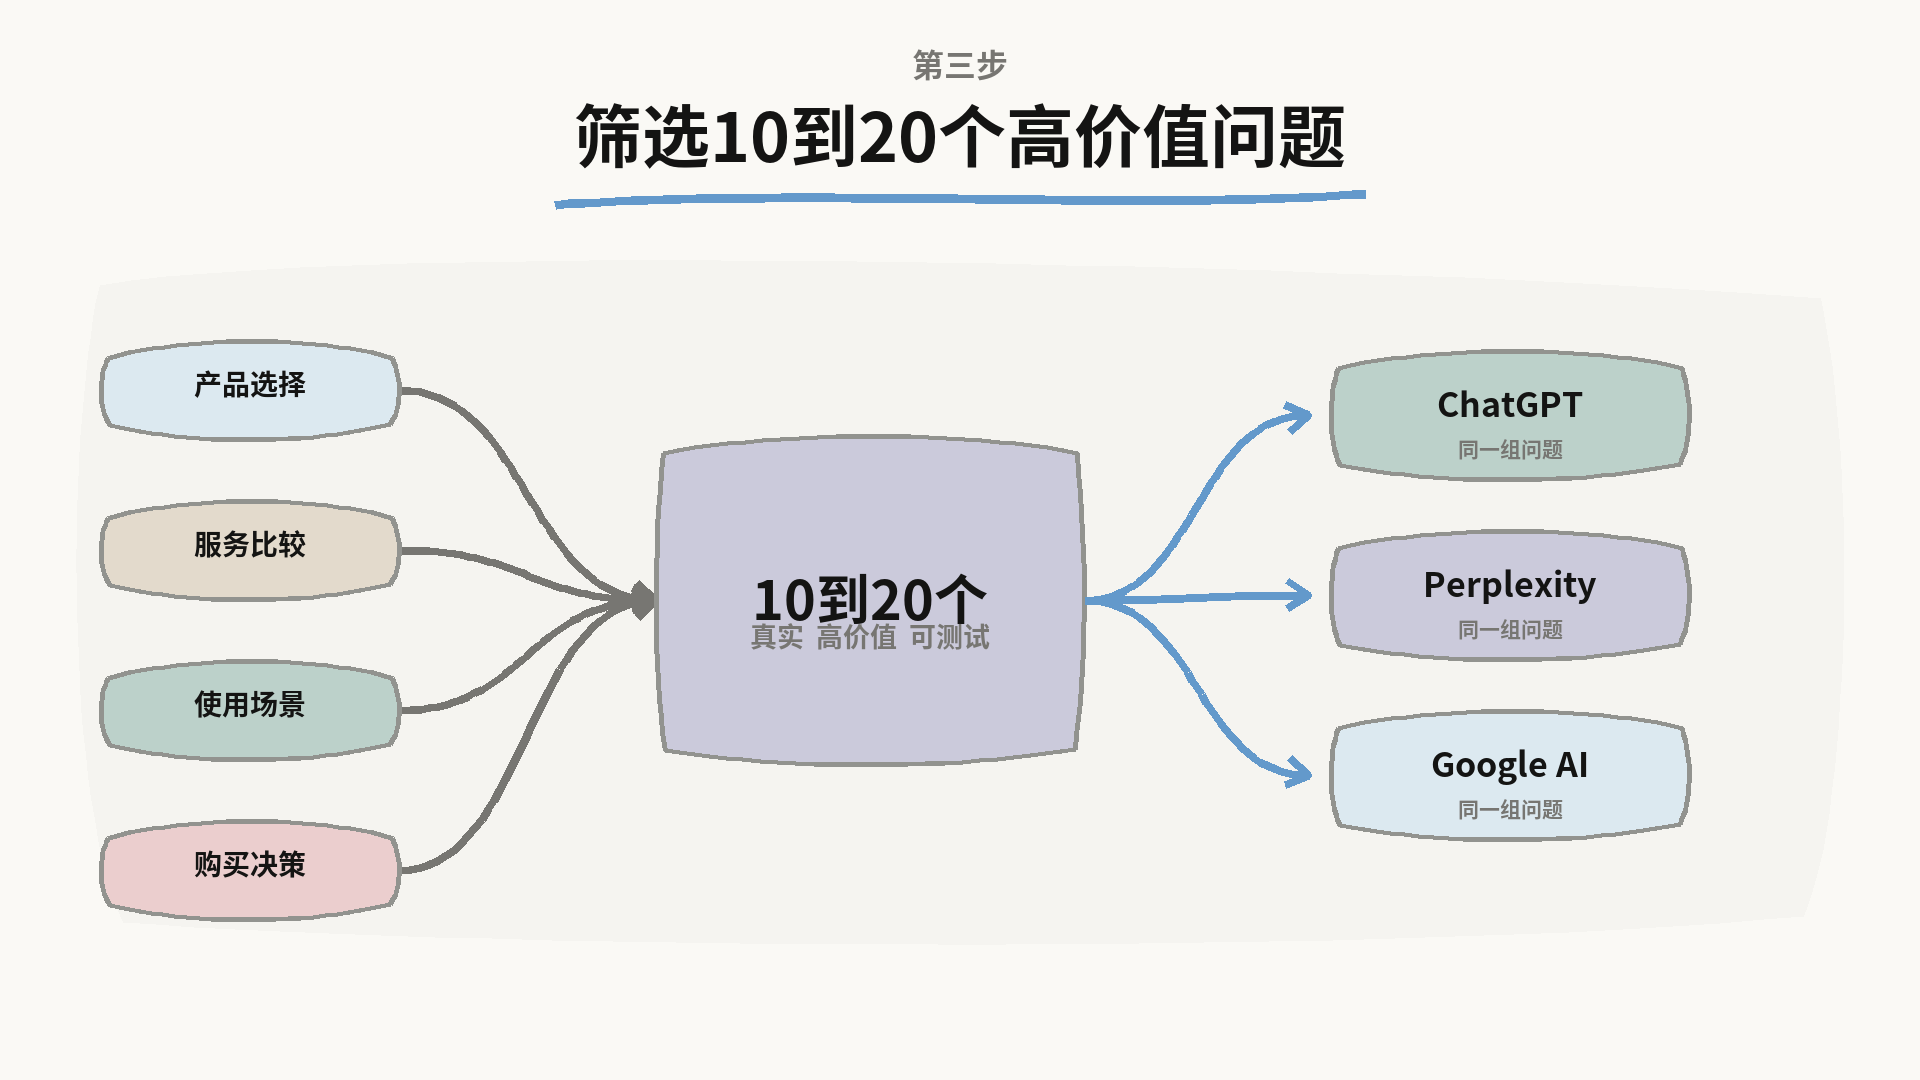
从所有问题中选出十到二十个高价值问题,优先选择与产品选择、服务比较、使用场景和购买决策关系较大的问题。
接下来,把这些问题分别放到 ChatGPT、Perplexity、Google AI 等平台测试,观察它们目前会怎样回答。想省去手动切换平台粘贴的麻烦,也可以直接用GEO 可见度判定助手一次性跑完主流引擎。
四、固定条件再重复测试
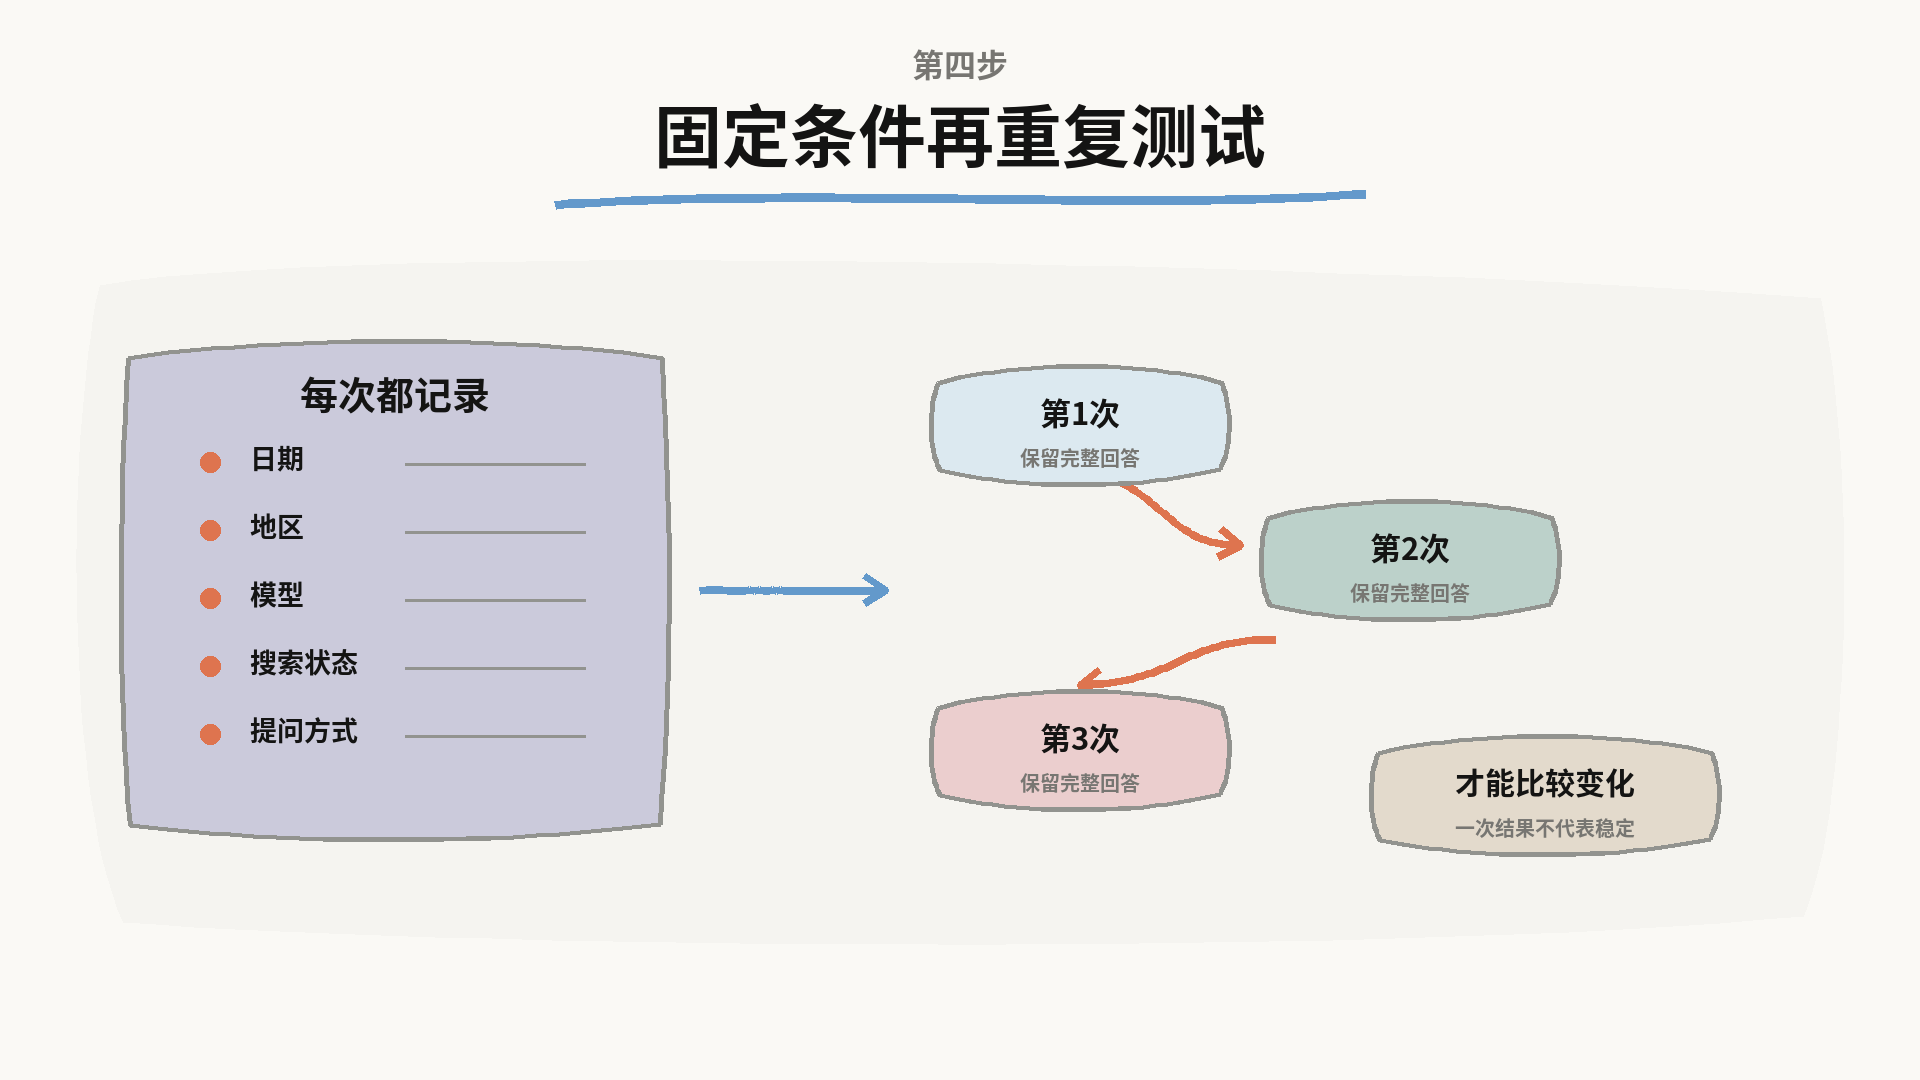
每次测试都要记录日期、地区、使用的模型、是否开启搜索,以及具体的提问方式。
同一个问题最好重复测试。AI 每次生成的答案可能不同,一次结果很难说明品牌已经稳定出现。
五、不要只记品牌有没有出现
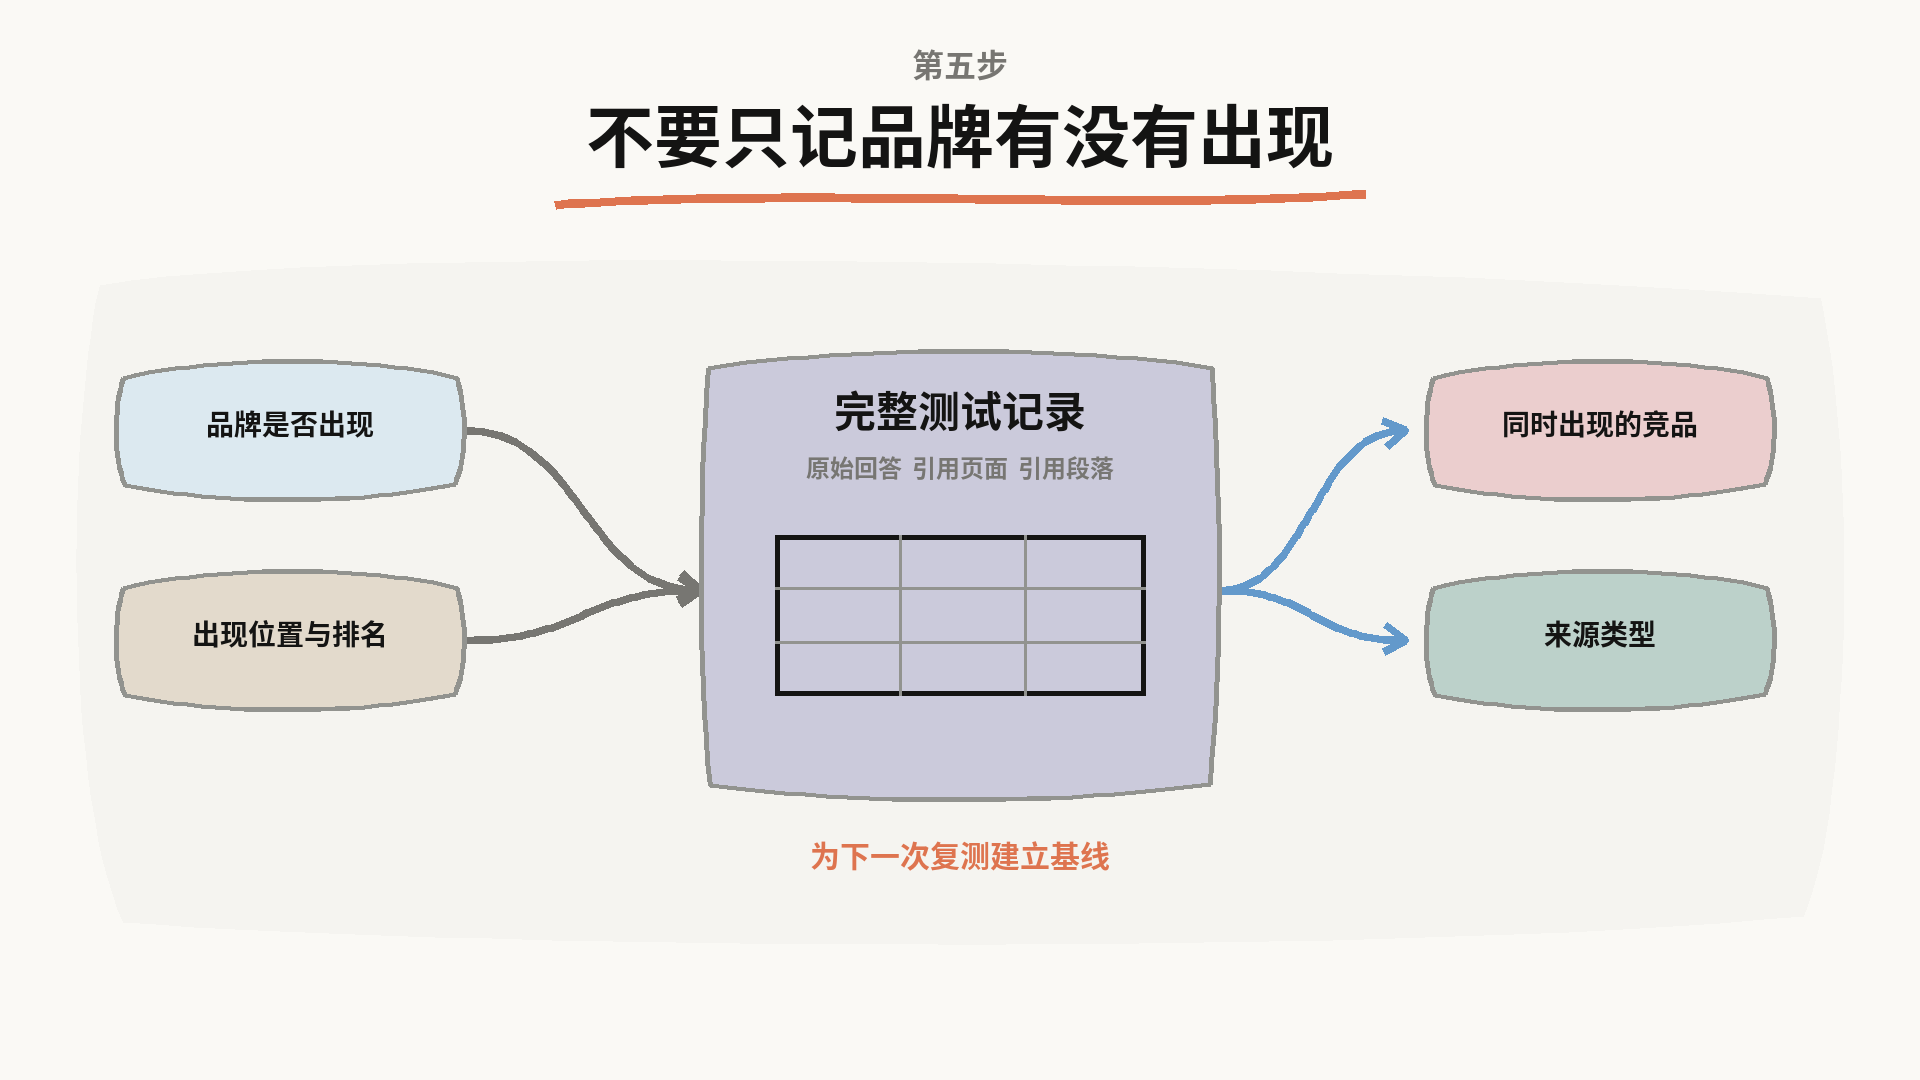
品牌有没有出现,排在什么位置,AI 引用了哪个页面,具体引用了哪一段,同时推荐了哪些竞品,这些信息都要记下来。
还要区分来源类型。它引用的是品牌官网、媒体报道、评测网站、论坛讨论,还是行业研究。
原始回答也要保留。后面再次测试时,才能知道具体发生了什么变化。
六、分析来源为什么适合回答
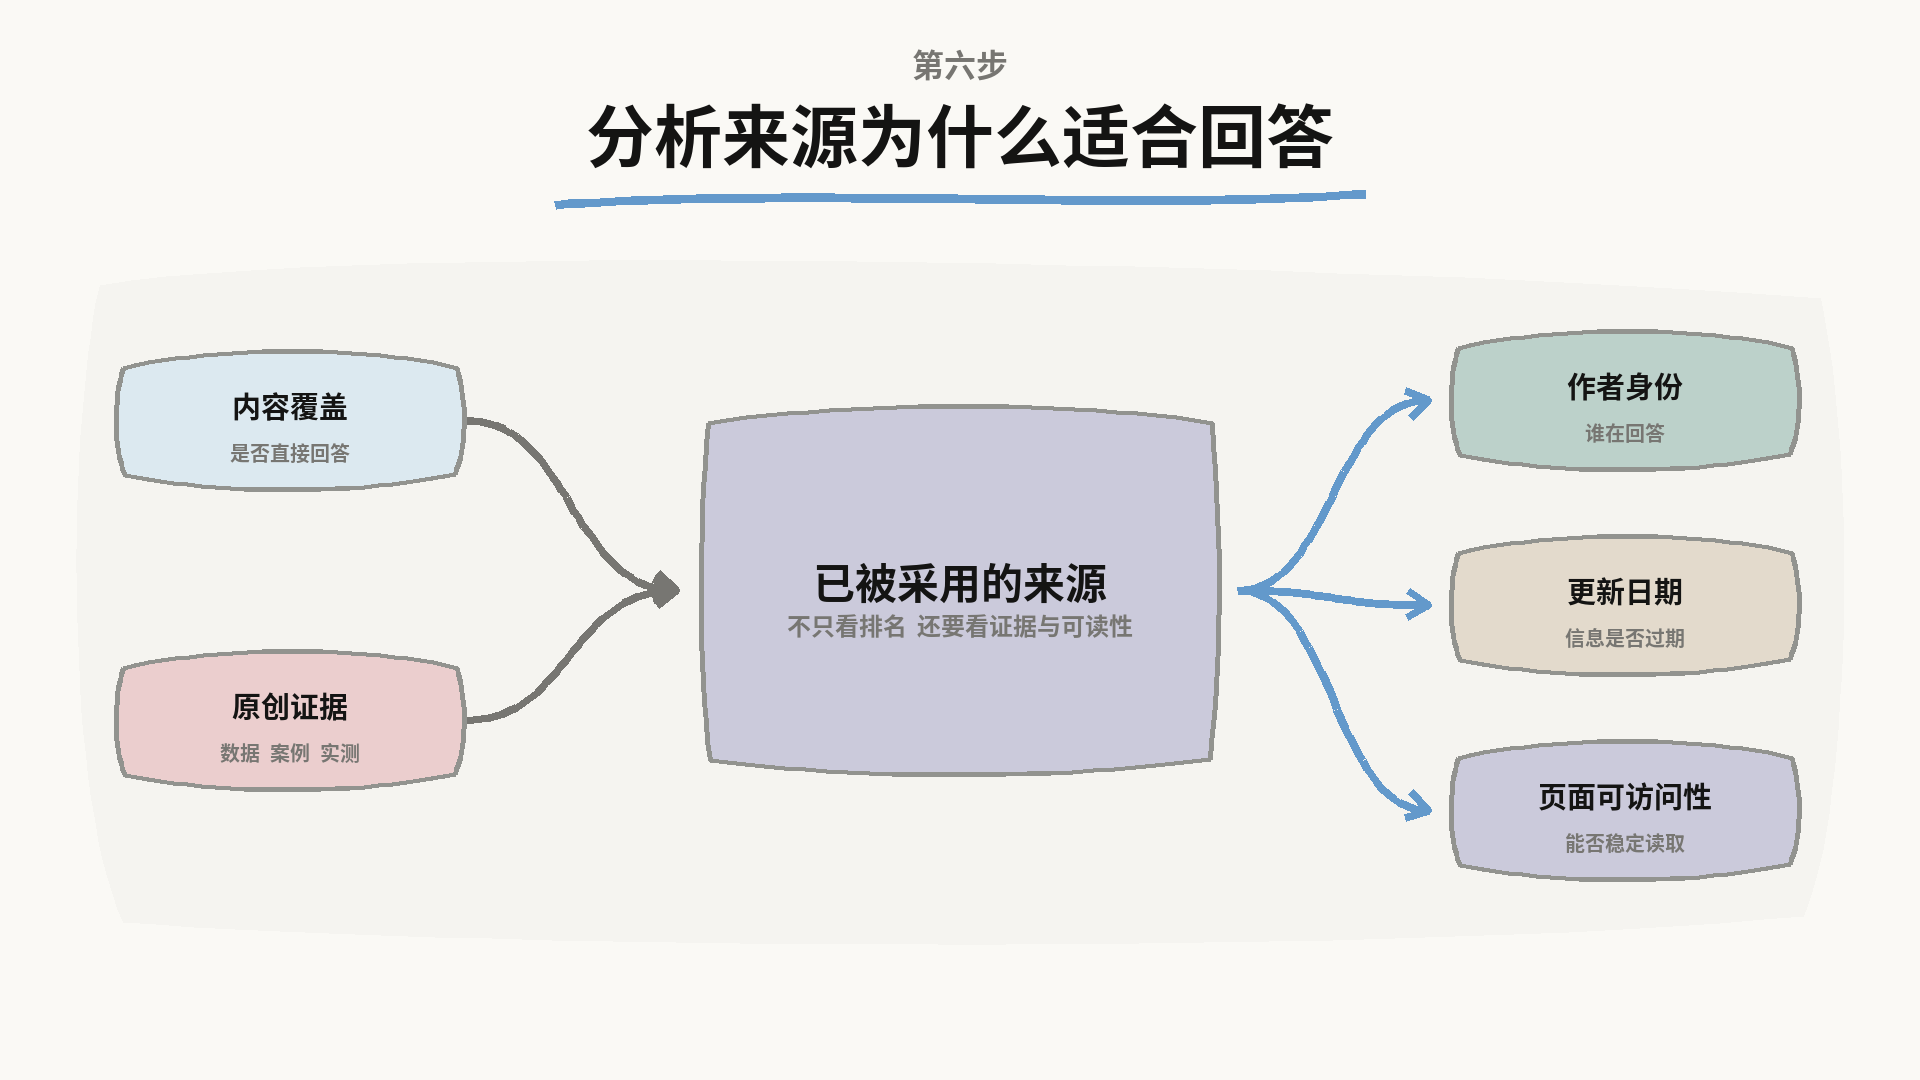
看看这些页面覆盖了哪些问题,有没有原创数据、真实案例或第一手经验。
同时检查作者身份是否清楚,内容是否及时更新,页面能不能正常访问,AI 能不能读取其中的主要信息。
这一步要找到的是内容差距。可能是我们的页面没有完整回答问题,也可能缺少证据、作者信息或清晰的更新时间。还有一种情况,页面内容不错,但访问和读取存在障碍。
七、按主题簇完善现有页面
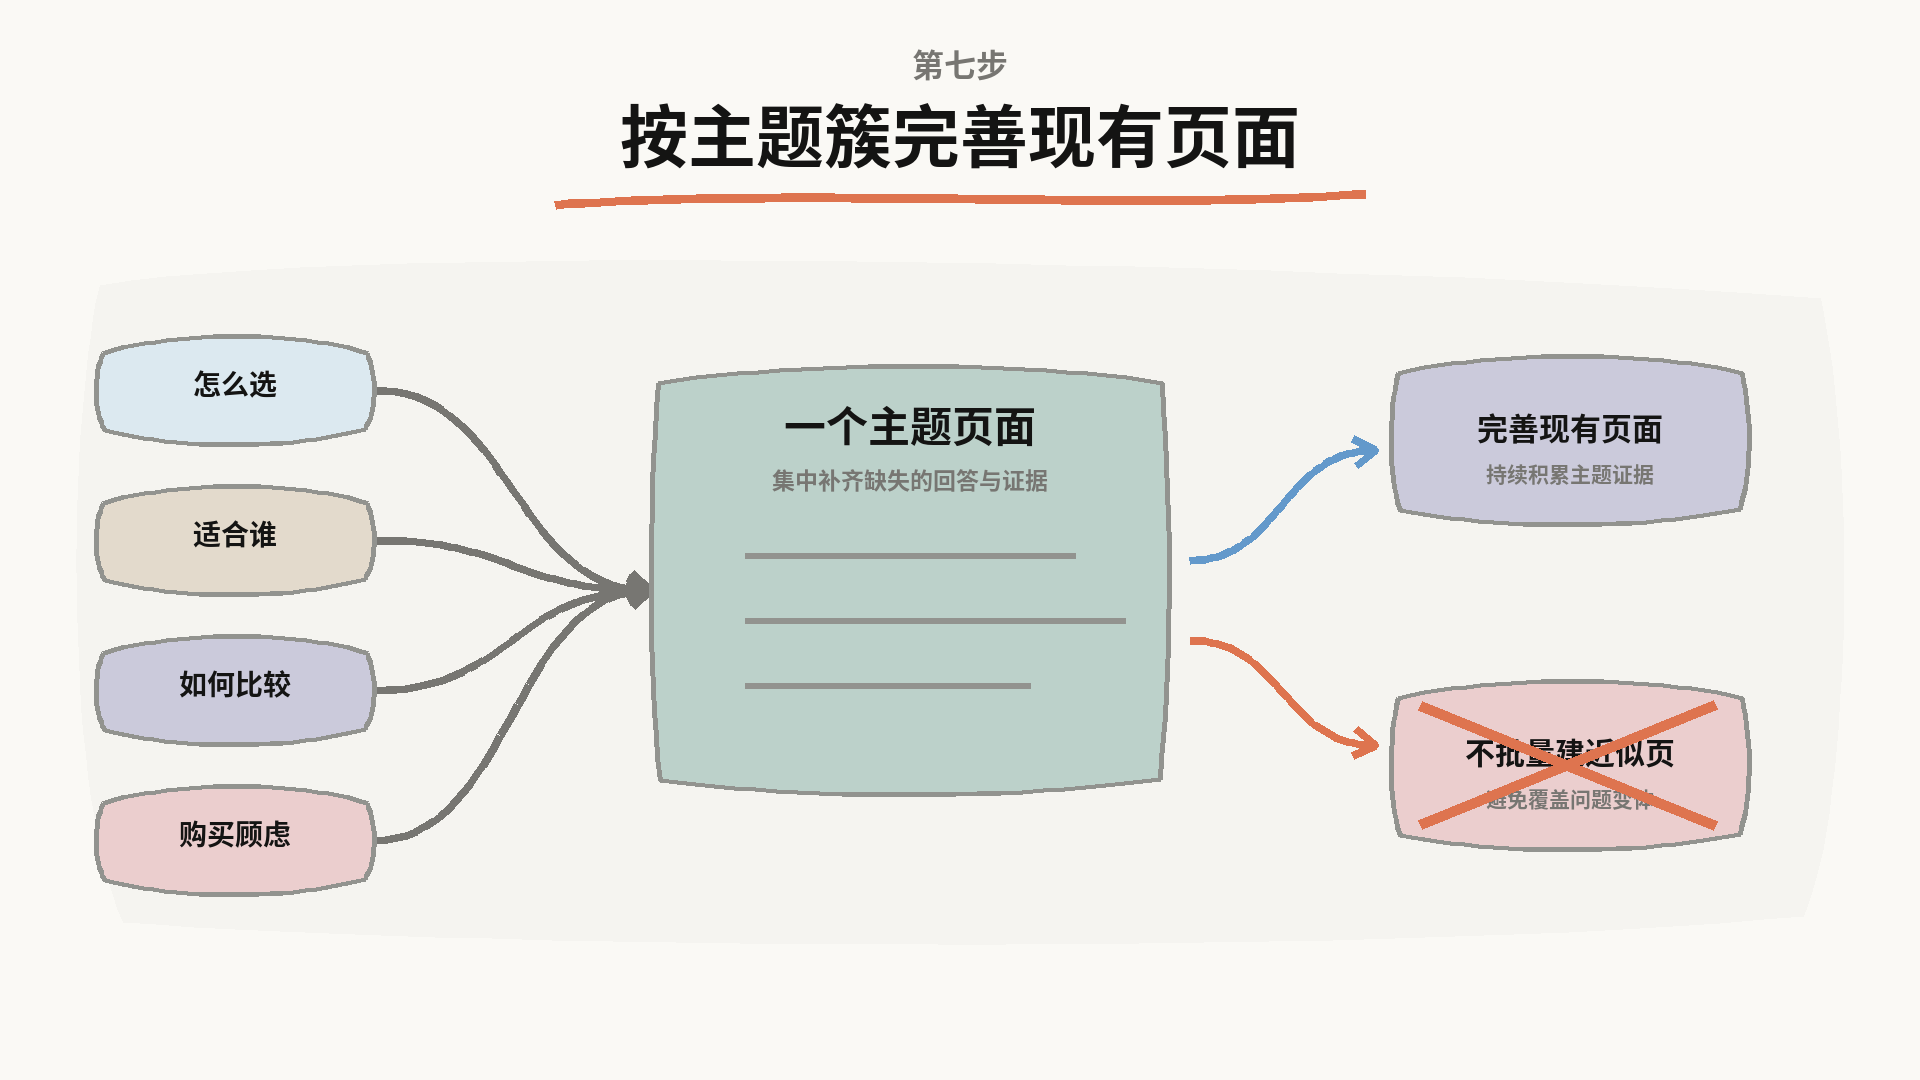
把意思接近的问题放在一起,判断它们能不能由同一个页面完整回答。
现有页面已经有基础,就在原页面补充缺少的内容、证据和说明。确实没有合适的承载页面,再考虑增加新内容。
不要每发现一个问题变体,就生成一篇高度相似的文章。Google 已经明确提醒,不要为了覆盖 AI 扩展出来的查询而批量制造页面。
八、发布以后定期复测
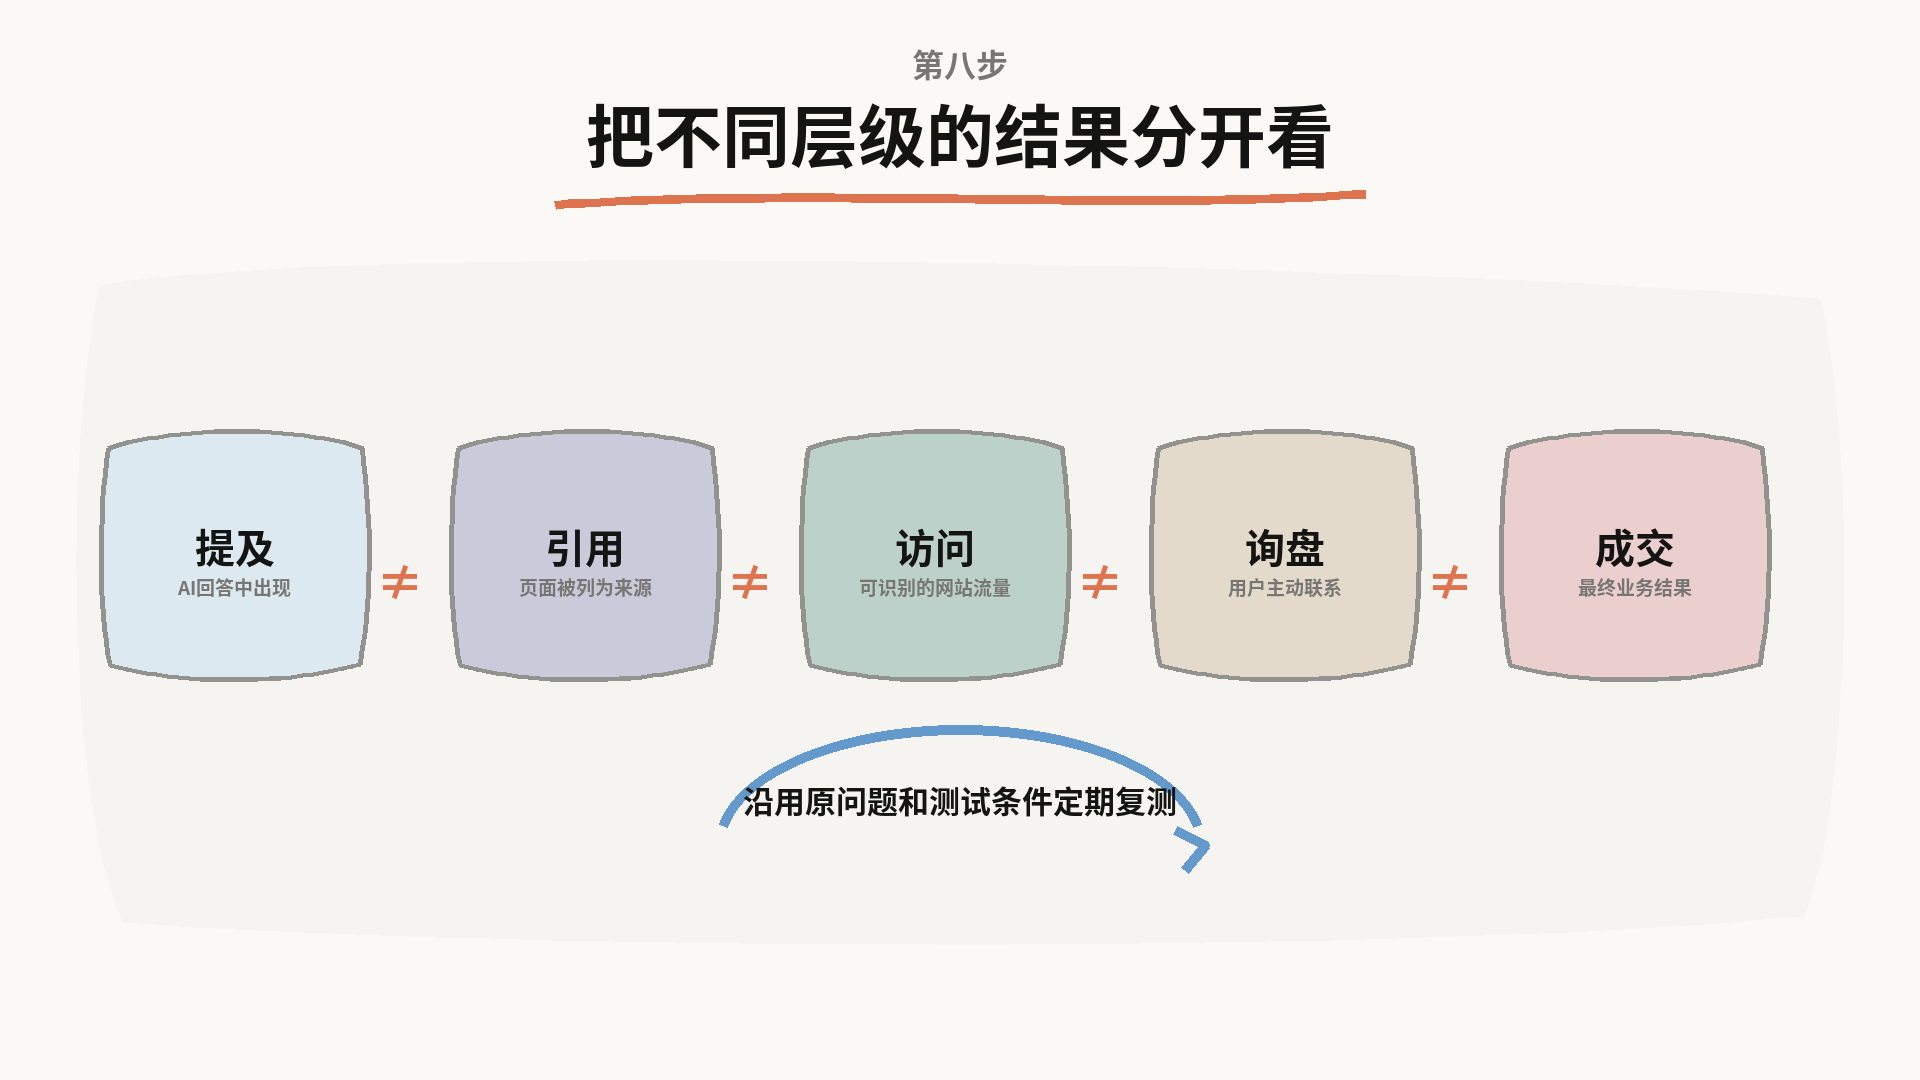
继续使用原来的问题和测试条件,观察品牌有没有出现,被引用的页面是否发生变化,竞品和来源类型有没有改变。
与此同时,分别记录 AI 提及、网页引用、可识别访问、询盘和成交。这些数据代表不同阶段,品牌被提到不等于用户访问了网站,产生访问也未必会带来咨询和成交。如果想把这几层结果拆得更细,可以参考六种可落地的 GEO 效果衡量方法。
九、跑完流程,你能拿到什么
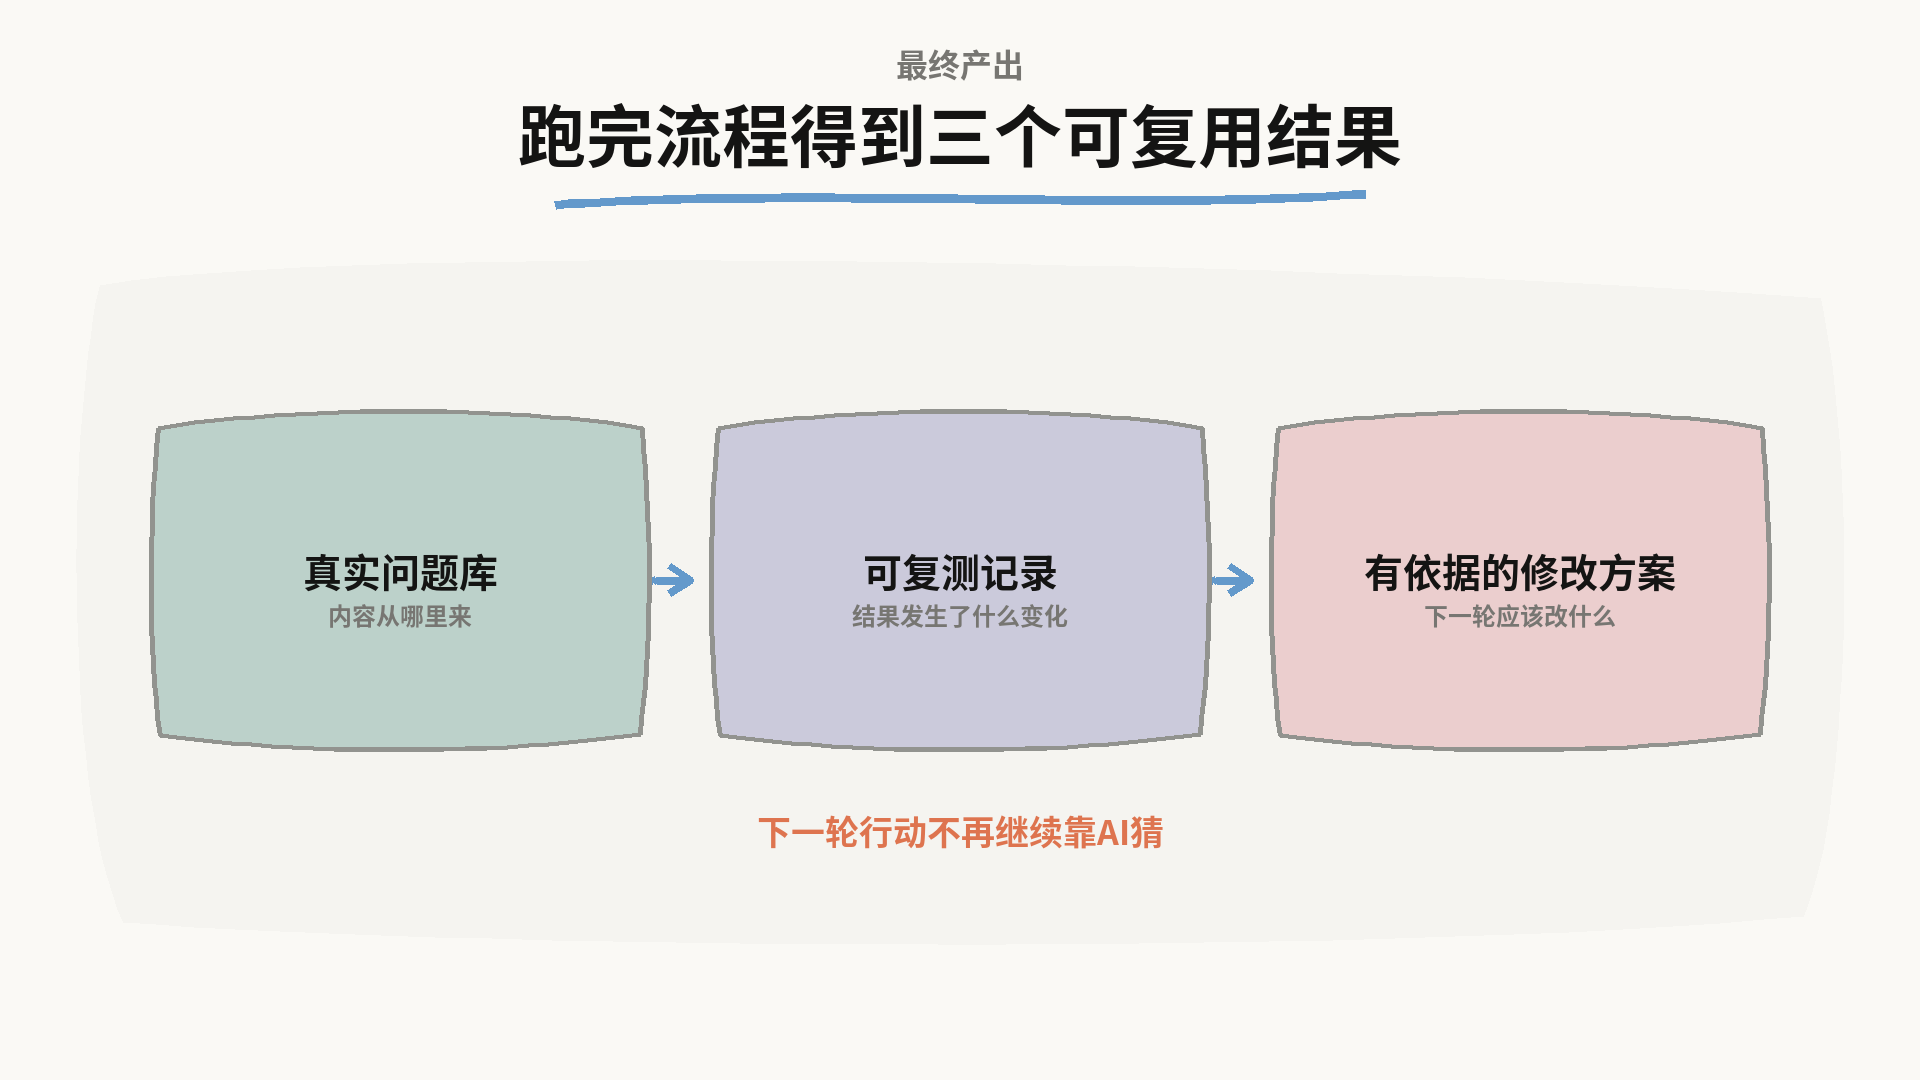
当这套流程跑完以后,你得到的会是一组来自真实用户的问题、一份可以重复执行的测试记录,以及一套有明确依据的内容修改方案。
下一轮要做什么,也不用继续靠 AI 猜。