做竞品分析最累的,往往是整理资料。
打开十几个网页,把功能、价格和用户评论抄进表格。最后表格填得很满,能支持决策的结论依然很少。
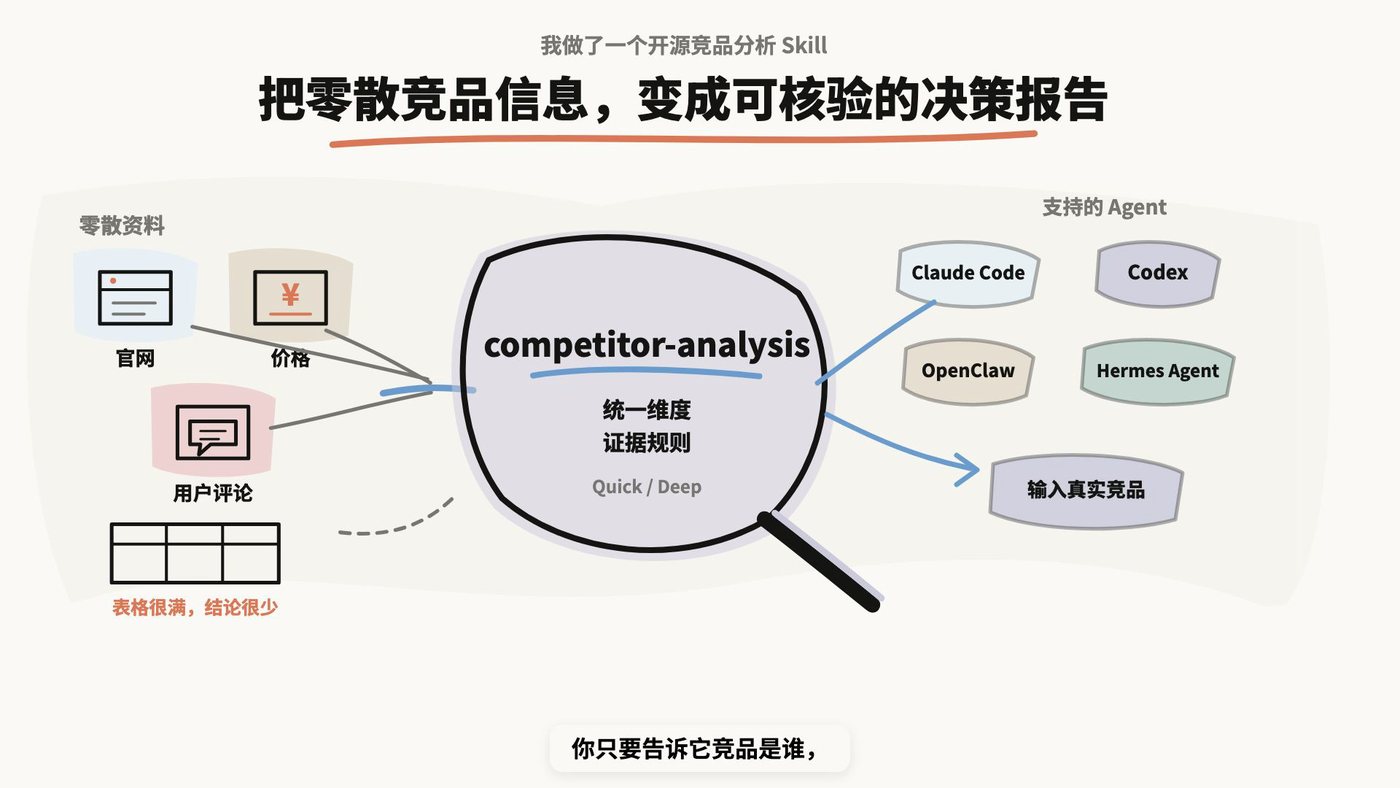
所以我做了一个开源的 competitor-analysis Skill。
装进 Claude Code、Codex、OpenClaw 或 Hermes Agent 以后,你只要告诉它竞品是谁,它就会查找公开资料,按照统一维度整理成中文报告。
我把它分成了四种模式。
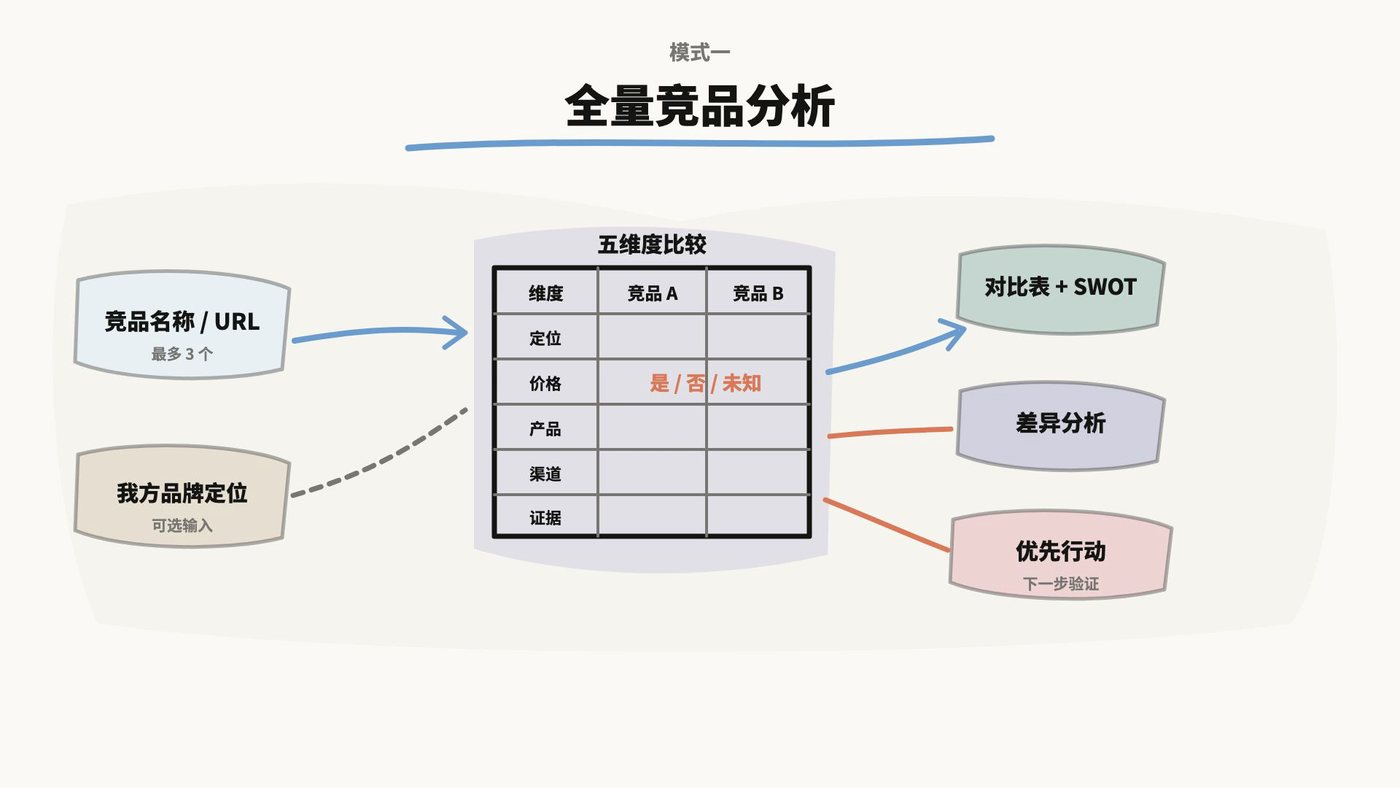
第一种是全量竞品分析。
给它竞品名称或者网址,它会用统一的五个维度进行比较,生成对比表和证据化 SWOT。 如果你再提供自己的品牌定位,它还会分析双方的差异,给出优先行动和下一步需要验证的信息。
第二种是舆情情感分析。
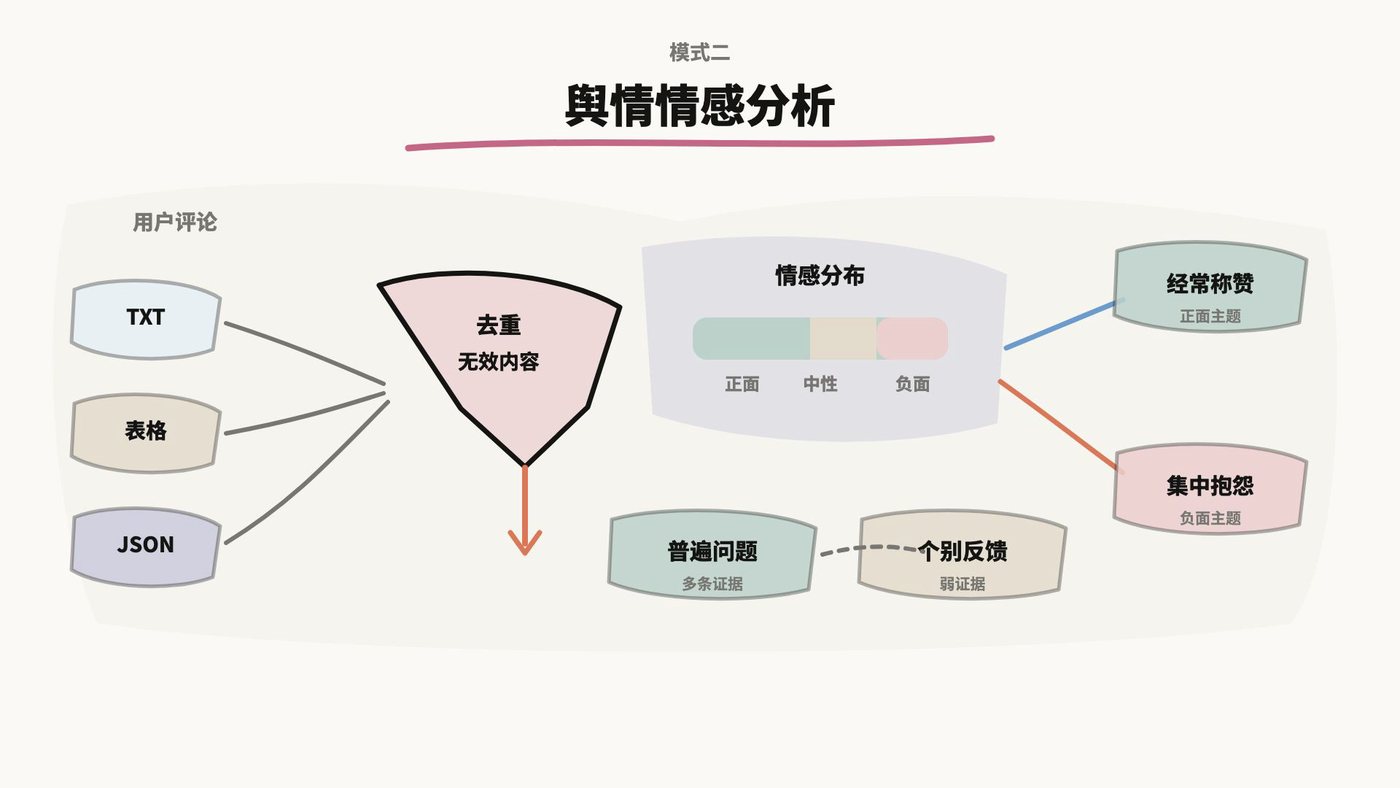
你可以把竞品的用户评论整理成文本、表格或者 JSON 交给它。
它会先处理重复和无效内容,再统计正面、中性和负面评价,找出用户经常称赞的地方,以及他们集中抱怨的问题。
报告还会区分普遍问题和个别反馈,避免用一两条差评代表所有用户。
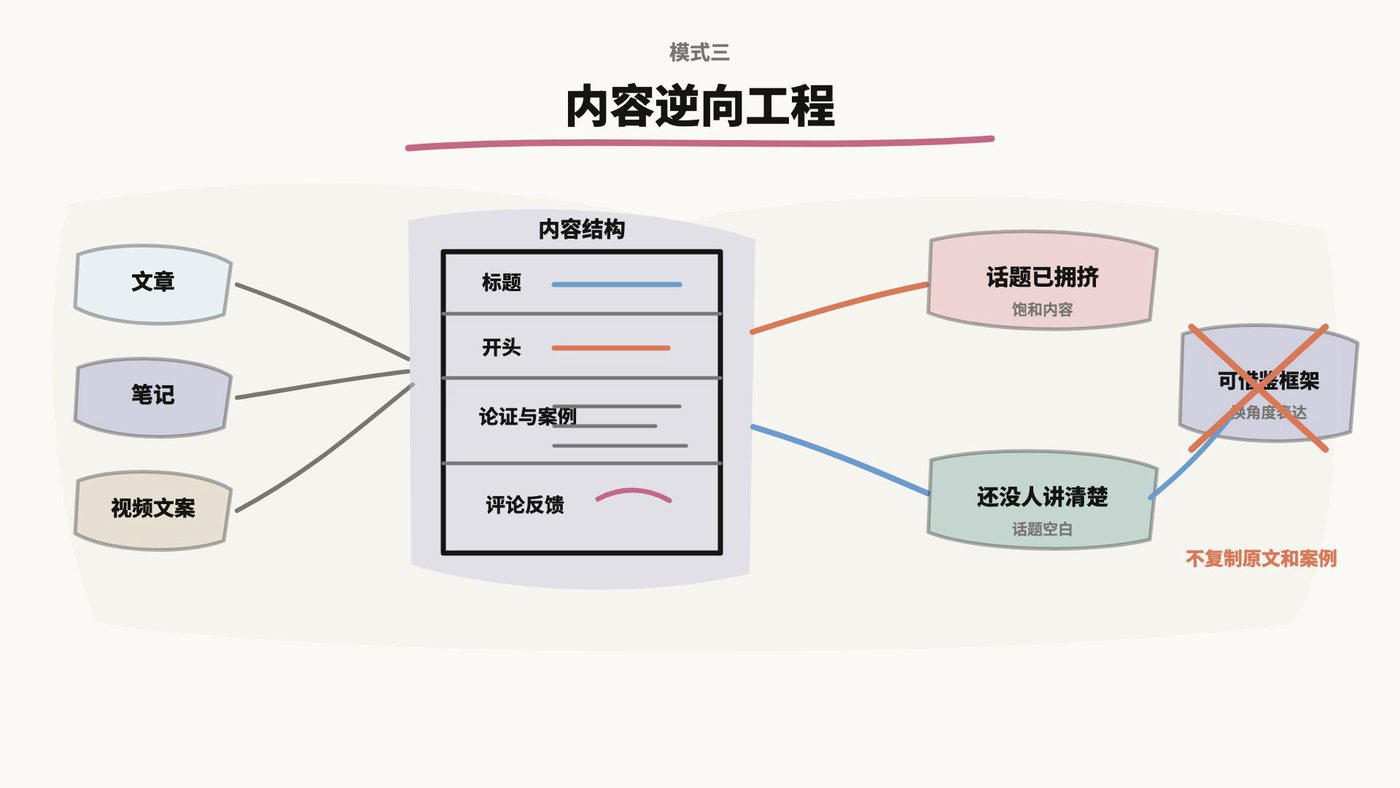
手里有竞品的文章、笔记或者视频文案时,可以使用第三种内容逆向工程。
它会从标题和开头一路分析到内容结构,找出竞品反复使用的表达方式。结合评论里的用户问题,还能判断哪些话题已经非常拥挤,哪些问题仍然没人讲清楚。
最后输出的是可以借鉴的内容框架,不会直接复制竞品的原文和案例。
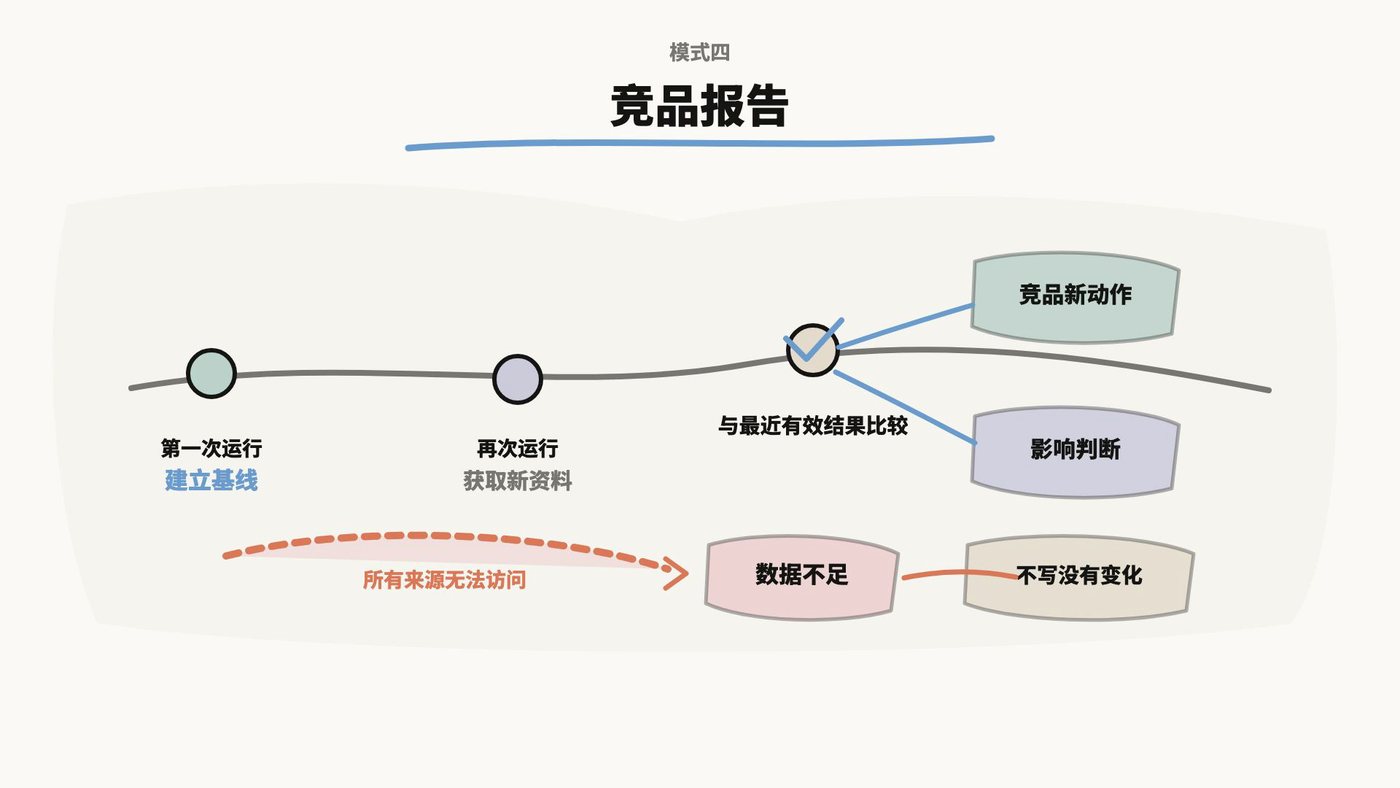
第四种是竞品报告。
第一次运行会建立一份基线。以后再次运行,它会和最近一次有效结果进行比较,整理竞品这段时间的新动作,并判断这些变化会带来什么影响。
如果所有来源都无法访问,报告会明确写数据不足,也不会把获取失败误判成竞品没有变化。
设计这个 Skill 时,我最看重证据是否可靠。
有来源支持的内容会标成已核实事实。根据材料得出的判断会标成推断。暂时查不到的信息就明确写成未知。
价格、销量和市场份额这类容易出错的信息,它还会提醒你再次验证。
普通需求默认使用 Quick 模式。想做更完整的正式报告,再明确要求 Deep。
它只使用公开网页和你主动提供的数据,不会绕过登录、验证码或者付费墙。竞品报告也需要手动运行,当前版本没有后台自动监控。
现在这个项目已经开源,安装命令和测试提示词都放在 GitHub。
如果你也在做市场、产品或者品牌,可以直接拿一个真实竞品试一下。